Chi gestisce un sito, un blog o una testata online potrà dire "no" all'addestramento dell'intelligenza artificiale con una sola voce nel file robots.txt. OpenAI, Google, Microsoft e Anthropic hanno annunciato venerdì 30 ottobre che rispetteranno un segnale comune, descritto in una bozza tecnica presentata lo stesso giorno all'Internet Engineering Task Force (IETF), l'organismo che definisce molti protocolli del web. Finora, per ottenere lo stesso risultato, bisognava bloccare uno per uno i crawler dei vari fornitori, inseguendo ogni nuovo nome.
La notizia ha avuto eco anche nella stampa tecnologica italiana. Vediamo come funziona, cosa copre davvero e cosa conviene fare.
Come si scrive la nuova regola
La bozza, intitolata "Machine-Readable Training Preference Signal", porta la firma di Kevin Kelley di Anthropic. Non inventa nuovi comandi: riusa la sintassi già fissata dal protocollo robots.txt (RFC 9309). Al posto del nome di un bot, nella riga User-Agent compare un "token di policy", __usage_ai-training. Per escludere l'intero sito:
User-Agent: __usage_ai-training
Disallow: /
Se invece si vuole lasciare disponibile una parte, per esempio l'area comunicati stampa, si aggiunge un'eccezione:
User-Agent: __usage_ai-training
Disallow: /
Allow: /comunicati/
Vale la regola consueta del robots.txt: prevale il percorso corrispondente più lungo. Due dettagli contano parecchio. Un gruppo generico User-Agent: * non viene letto come preferenza sull'addestramento, quindi chi oggi blocca tutti i bot su certe cartelle non ha ancora espresso un opt-out. E se il token manca del tutto, per la bozza nessuna preferenza è stata indicata.
Cosa copre e cosa no
Per "addestramento" la bozza intende l'uso di un contenuto per modificare i parametri appresi di un modello di IA generativa. Restano fuori i modelli che svolgono solo compiti non generativi, come un classificatore di spam.
Il token, inoltre, non è un blocco del crawling: indica come un contenuto può essere usato, ma non impedisce di per sé lo scaricamento della pagina. Chi vuole tenere lontani i bot deve continuare a usare le regole per i singoli crawler. Il testo prevede anche che eventuali accordi privati, come una licenza tra editore e società di IA, possano avere la precedenza sul segnale. Infine, l'effetto riguarda solo la raccolta futura: i modelli già addestrati non vengono toccati.
Chi lo applica e quando
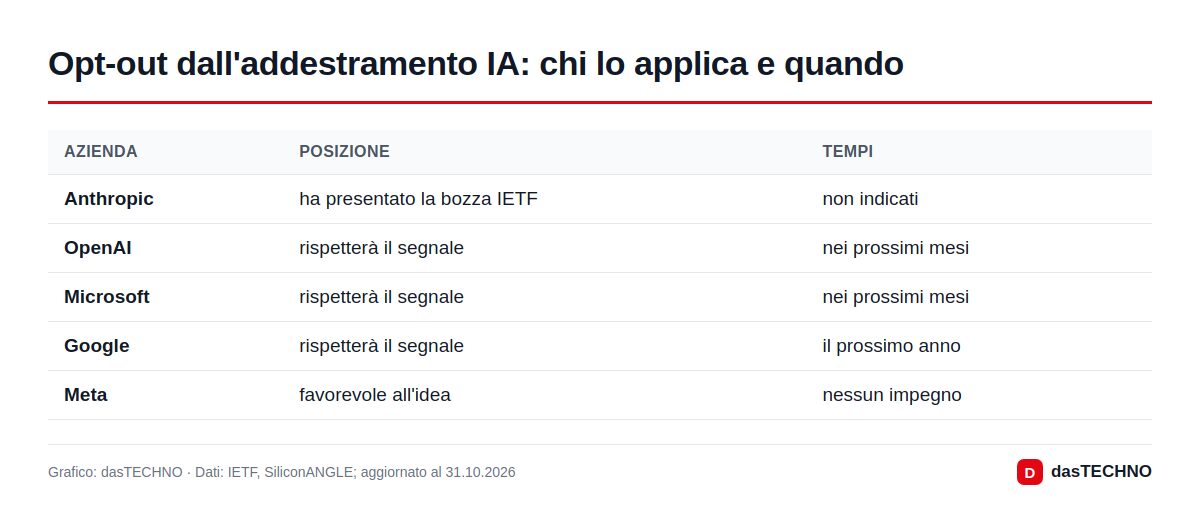
Secondo SiliconANGLE, OpenAI e Microsoft rispetteranno il segnale "nei prossimi mesi", Google nel corso del prossimo anno, senza un mese preciso. Meta si è detta favorevole all'idea ma non ha preso impegni. Microsoft affianca un'impostazione separata, chiamata AI Grounding, per decidere se le pagine possano essere richiamate in tempo reale per generare risposte.
Lo stato formale va ricordato: è una bozza individuale, non uno standard approvato dall'IETF, e scade il 3 maggio 2027 se non verrà portata avanti.
Cosa significa per editori e siti italiani
In Europa la questione ha anche un risvolto giuridico. La direttiva UE sul diritto d'autore del 2019, recepita in Italia nel 2021, consente l'estrazione di testo e dati salvo che il titolare se lo sia riservato in modo appropriato, per i contenuti online con strumenti leggibili da una macchina. L'AI Act chiede poi ai fornitori di modelli di IA per finalità generali di rispettare queste riserve. Un token unico rende più semplice documentarle in modo tecnicamente chiaro; se basti da solo sul piano legale lo diranno le prassi e i giudici, e questo articolo non è una consulenza legale.
In pratica:
- Aggiungere la nuova voce senza togliere le vecchie. Le regole per GPTBot, Google-Extended e simili restano utili, anche perché Google partirà solo l'anno prossimo.
- Distinguere addestramento e ricerca. Chi vuole comparire, con link, nelle risposte dei chatbot non deve bloccare in blocco tutti i bot IA.
- Non aspettarsi controlli esterni. L'adesione resta volontaria e la bozza non prevede verifiche indipendenti.
Il tema dello scraping è caldo da tempo: Reddit, per esempio, sta provando a rendere obbligatorio il login per leggere, e Bruxelles ha inviato le prime richieste formali dell'AI Act a OpenAI e Anthropic.
Domande frequenti
Bisogna modificare subito il robots.txt?
Non è obbligatorio. Chi vuole escludere l'addestramento può però aggiungere la voce già ora: non crea problemi e conterà quando le aziende inizieranno a leggerla.
Basta "User-Agent: *" con "Disallow: /"?
No. Secondo la bozza il gruppo generico non vale come preferenza sull'addestramento: serve un gruppo dedicato con __usage_ai-training.
I contenuti già usati verranno rimossi dai modelli?
No. Il segnale vale solo per l'addestramento futuro.
È già uno standard ufficiale?
No. È una bozza individuale presentata all'IETF il 30 ottobre 2026, non ancora approvata.