Wer seine Website bislang vor dem KI-Training schützen wollte, musste in der robots.txt jeden Crawler einzeln aussperren: GPTBot für OpenAI, Google-Extended für Google, dazu weitere Einträge für jeden neuen Anbieter. Das soll künftig mit einem einzigen Eintrag gehen. OpenAI, Google, Microsoft und Anthropic haben am Freitag, 30. Oktober 2026, angekündigt, ein gemeinsames Opt-out-Signal zu respektieren. Die technische Grundlage ist ein Entwurf, den Anthropic bei der Internet Engineering Task Force (IETF) eingereicht hat. Für Verlage, Blogger und Shopbetreiber in Deutschland ist das eine der praktischsten Neuerungen seit Langem, allerdings mit einigen Haken.
So sieht der neue Eintrag aus
Der Entwurf trägt den Titel „Machine-Readable Training Preference Signal“ und führt keine neue Syntax ein. Stattdessen nutzt er die bekannte User-Agent-Zeile, allerdings nicht mit dem Namen eines Crawlers, sondern mit einem sogenannten Policy-Token: __usage_ai-training. Wer generell nicht möchte, dass seine Inhalte in KI-Modelle einfließen, ergänzt die robots.txt so:
User-Agent: __usage_ai-training
Disallow: /
Sollen einzelne Bereiche ausdrücklich für das Training freigegeben werden, etwa ein Pressebereich, kommt eine Allow-Zeile dazu:
User-Agent: __usage_ai-training
Disallow: /
Allow: /presse/
Es gilt die aus RFC 9309 bekannte Regel: Der längste passende Pfad entscheidet. Wichtig sind zwei Details aus dem Entwurf. Erstens zählt eine allgemeine Gruppe mit User-Agent: * nicht als Training-Präferenz. Wer also schon heute bestimmte Pfade für alle Bots sperrt, hat damit noch kein Opt-out erklärt. Zweitens bedeutet eine robots.txt ohne das Token schlicht: keine Präferenz geäußert.
Was genau gilt als „KI-Training“?
Der Entwurf definiert Training als Nutzung eines Inhalts, um die gelernten Parameter eines generativen KI-Modells zu verändern. Modelle, die ausschließlich nicht-generative Aufgaben erledigen, sind ausdrücklich ausgenommen, etwa ein reiner Spam- oder Bildklassifikator.
Ebenso wichtig: Das Token ist keine Crawling-Sperre. Es drückt aus, wie Inhalte verwendet werden dürfen, und kann Crawling-Entscheidungen beeinflussen, verhindert aber nicht den Abruf der Seite. Wer Bots tatsächlich aussperren will, braucht weiterhin die Einträge für die jeweiligen Crawler. Zudem heißt es im Entwurf, dass private Vereinbarungen, etwa Lizenzverträge zwischen Verlag und KI-Firma, Vorrang vor dem Signal haben können.
Wer setzt das Signal wann um?
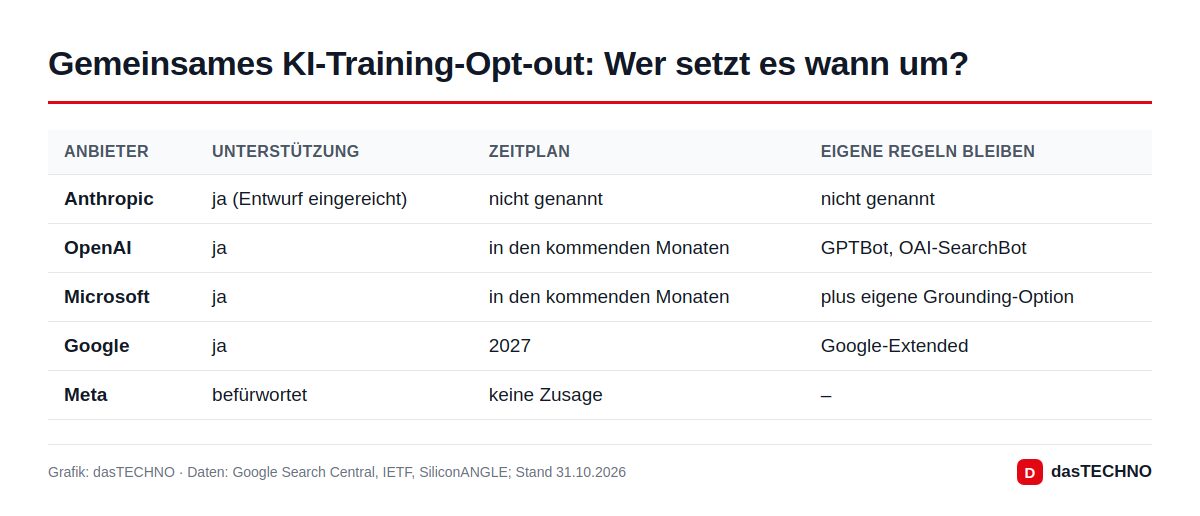
Bei den Zeitplänen gibt es deutliche Unterschiede:
| Anbieter | Haltung | Zeitplan |
|---|---|---|
| Anthropic | hat den Entwurf eingereicht | nicht genannt |
| OpenAI | will das Signal beachten | in den kommenden Monaten |
| Microsoft | will das Signal beachten, plus eigene Grounding-Option | in den kommenden Monaten |
| will das Signal beachten | 2027 | |
| Meta | befürwortet die Idee | keine Zusage |
Google erklärt im Search-Central-Blog, ein Opt-out über das neue Token wie ein Verbot von Google-Extended zu behandeln, sofern Google-Extended in der Datei nicht ausdrücklich genannt ist. Eine explizite Regel für Google-Extended hat also Vorrang. Google weist zudem darauf hin, dass Seiten, die Google-Extended ausdrücklich erlauben, über das sogenannte Grounding in Antworten der Gemini-Apps erscheinen und Klicks erhalten können.
OpenAI betont, dass die bisherigen Steuerungen über GPTBot und OAI-SearchBot weiter gelten. Details zur Umsetzung will das Unternehmen separat nachreichen.
Microsoft geht einen Schritt weiter und kündigt zusätzlich eine eigene Einstellung namens AI Grounding an. Damit sollen Betreiber getrennt festlegen können, ob ihre Seiten von Copilot und anderen KI-Antworten live abgerufen und verlinkt werden dürfen. Die Sichtbarkeit in der klassischen Bing-Suche soll davon nicht berührt werden.
Was bedeutet das für Websitebetreiber in Deutschland?
Für deutsche Verlage hat die Ankündigung auch eine rechtliche Komponente. Google verweist darauf, dass der Vorschlag zum Verhaltenskodex für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck (GPAI Code of Practice) unter dem EU AI Act passt. Dieser erkennt die robots.txt als zentrales Mittel an, mit dem Webseitenbetreiber maschinenlesbar ihre Präferenzen äußern. Ein einheitliches Token macht es leichter, einen Nutzungsvorbehalt technisch sauber zu dokumentieren.
Praktisch empfiehlt sich Folgendes:
- Den neuen Eintrag ergänzen, nicht ersetzen. Bestehende Regeln für GPTBot, Google-Extended oder andere Crawler bleiben sinnvoll, zumal die Umsetzung bei Google erst 2027 kommt.
- Bewusst zwischen Training und Suche trennen. Wer in KI-Suchen und Chatbot-Antworten mit Link auftauchen möchte, sollte nicht pauschal alle KI-Bots sperren, sondern nur das Training ausschließen.
- Keine Wunder erwarten. Inhalte, die bereits in trainierten Modellen stecken, holt das Signal nicht zurück. Und es bleibt eine freiwillige Selbstverpflichtung; eine unabhängige Kontrolle, ob sich Anbieter daran halten, sieht der Entwurf nicht vor.
Wer seine KI-Nutzung als Privatperson einschränken möchte, findet die passenden Schalter in unserem Ratgeber zu Datenschutz-Einstellungen bei ChatGPT, Gemini und Claude.
Hintergrund: Streit um Trainingsdaten
Die Initiative kommt nicht aus dem Nichts. Verlage, Künstler und Plattformen werfen KI-Firmen seit Jahren vor, ihre Inhalte ungefragt zu verwerten. Zuletzt prüfte etwa der Grüffelo-Zeichner Axel Scheffler rechtliche Schritte gegen OpenAI, und Reddit kündigte das Ende seiner RSS-Feeds und der öffentlichen API an.
An der zuständigen IETF-Arbeitsgruppe AIPREF beteiligen sich neben KI-Firmen auch Medienhäuser, Bürgerrechtsorganisationen und Creative Commons. Der jetzige Entwurf ist allerdings ein Einzelentwurf ohne offiziellen IETF-Status und läuft am 3. Mai 2027 aus, sofern er nicht weiterentwickelt wird. Bis daraus ein echter Standard wird, dürften Monate vergehen.
Häufige Fragen
Muss ich meine robots.txt jetzt ändern?
Nein, Pflicht ist das nicht. Wer KI-Training ausschließen möchte, kann den Eintrag aber schon jetzt ergänzen. Er schadet nicht und wird wirksam, sobald die Anbieter ihn auswerten.
Verschwinde ich damit aus der Google-Suche?
Nein. Das Token betrifft laut Google nur das KI-Training und wird wie ein Verbot von Google-Extended behandelt. Die normale Indexierung durch den Googlebot bleibt davon unberührt.
Werden bereits gesammelte Daten gelöscht?
Nein. Das Signal gilt nur für künftiges Training. Bereits trainierte Modelle werden nicht verändert.
Reicht „User-Agent: *“ mit „Disallow: /“ als Opt-out?
Nach dem Entwurf nicht. Eine allgemeine Gruppe wird ausdrücklich nicht als Training-Präferenz gewertet. Nötig ist eine eigene Gruppe mit __usage_ai-training.