Wie een website, blog of webshop beheert, kan AI-bedrijven straks met één regel in robots.txt laten weten dat de teksten niet voor AI-training gebruikt mogen worden. OpenAI, Google, Microsoft en Anthropic maakten op vrijdag 30 oktober bekend dat ze zo'n gezamenlijk signaal gaan respecteren. De technische uitwerking staat in een concept dat dezelfde dag bij de Internet Engineering Task Force (IETF) is ingediend. Tot nu toe moest u elke AI-crawler apart blokkeren, en bij elke nieuwe aanbieder opnieuw.
Ook in Nederland en België kreeg het nieuws de nodige aandacht. Hieronder leest u hoe de regel eruitziet, wat hij wel en niet doet en wat u er nu mee kunt.
Hoe ziet de nieuwe regel eruit?
Het concept heet "Machine-Readable Training Preference Signal" en is geschreven door Kevin Kelley van Anthropic. Er komt geen nieuwe syntaxis bij: het voorstel gebruikt de bestaande regels van het robots.txt-protocol (RFC 9309). In de User-Agent-regel staat alleen geen botnaam, maar een zogenoemd policy-token: __usage_ai-training. Om de hele site uit te sluiten:
User-Agent: __usage_ai-training
Disallow: /
Wilt u een deel juist wel beschikbaar stellen, bijvoorbeeld uw persberichten, dan voegt u een uitzondering toe:
User-Agent: __usage_ai-training
Disallow: /
Allow: /pers/
Zoals altijd bij robots.txt wint het langste overeenkomende pad. Let op twee punten. Een algemene groep met User-Agent: * telt niet als voorkeur over AI-training; wie nu al mappen voor alle bots afschermt, heeft dus nog geen opt-out geregeld. En staat het token er helemaal niet in, dan geldt volgens het concept: geen voorkeur uitgesproken.
Wat valt er wel en niet onder?
Met "training" bedoelt het concept het gebruik van content om de geleerde parameters van een generatief AI-model aan te passen. Modellen die alleen niet-generatieve taken uitvoeren, zoals een spamfilter, vallen erbuiten.
Belangrijk: het token is geen crawlblokkade. Het zegt iets over het gebruik van content, maar houdt bots niet tegen om pagina's op te halen. Wie crawlers echt wil weren, heeft de regels per bot nog steeds nodig. Daarnaast kunnen private afspraken, zoals een licentiedeal tussen uitgever en AI-bedrijf, volgens de tekst voorgaan op het signaal. En het werkt alleen vooruit: modellen die al getraind zijn, blijven zoals ze zijn.
Wie past het toe, en wanneer?
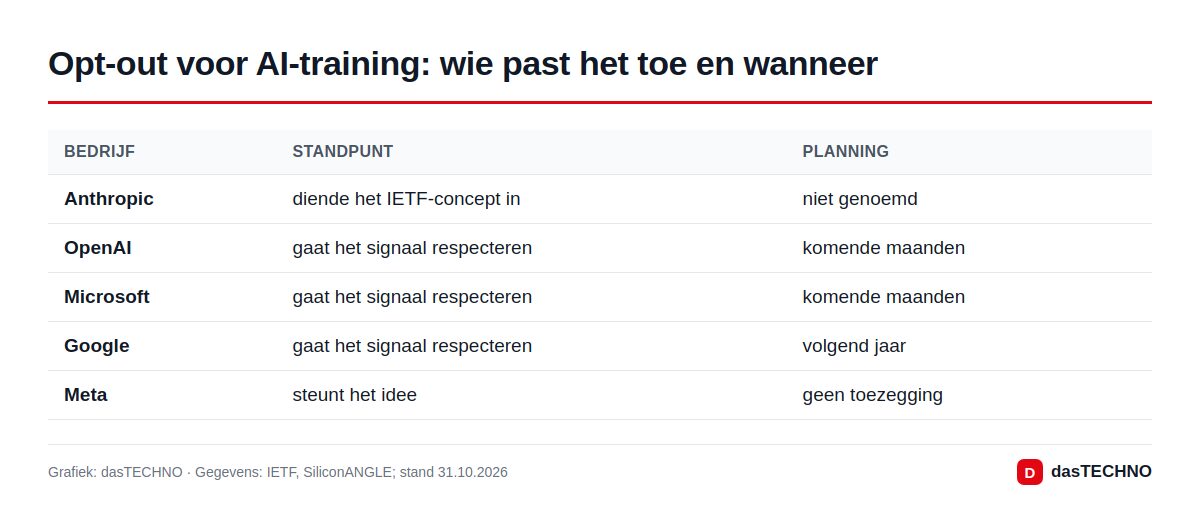
Volgens SiliconANGLE gaan OpenAI en Microsoft het signaal "in de komende maanden" respecteren. Google volgt ergens volgend jaar; een maand is niet genoemd. Meta zegt het idee te steunen, maar heeft niets toegezegd. Microsoft introduceert daarnaast een aparte instelling, AI Grounding, waarmee u kunt aangeven of pagina's live mogen worden opgehaald om AI-antwoorden te genereren.
Formeel is het nog geen standaard: het gaat om een individueel concept zonder IETF-goedkeuring, dat op 3 mei 2027 verloopt als er niet verder aan wordt gewerkt.
Wat betekent dit voor sites in Nederland en België?
Binnen de EU speelt ook het auteursrecht mee. De Europese auteursrechtrichtlijn uit 2019 staat tekst- en datamining toe, tenzij de rechthebbende dat op passende wijze heeft voorbehouden, bij online content via machineleesbare middelen. Nederland en België hebben die regel in hun wetgeving overgenomen, en de AI-verordening verplicht aanbieders van AI-modellen voor algemene doeleinden om zulke voorbehouden te respecteren. Eén vast token maakt het makkelijker om zo'n voorbehoud technisch eenduidig vast te leggen. Of dat juridisch altijd volstaat, moet de praktijk uitwijzen; dit artikel is geen juridisch advies. Voor Belgische en Nederlandse sites werkt het signaal hetzelfde.
Praktisch advies:
- Voeg de nieuwe regel toe, maar laat de oude staan. Regels voor GPTBot, Google-Extended en andere crawlers blijven nuttig, zeker omdat Google pas volgend jaar meedoet.
- Maak onderscheid tussen training en zoeken. Wilt u met een link in AI-antwoorden verschijnen, blokkeer dan niet zomaar alle AI-bots.
- Reken niet op controle. Meedoen is vrijwillig en het concept voorziet niet in onafhankelijk toezicht.
De strijd om webdata loopt al langer. Reddit test bijvoorbeeld verplicht inloggen om scraping tegen te gaan, en eerder kwam Meta onder vuur te liggen met een opt-out voor AI-training bij zijn camerabril.
Veelgestelde vragen
Moet ik mijn robots.txt nu aanpassen?
Verplicht is het niet. Wilt u AI-training uitsluiten, dan kunt u de regel nu al toevoegen; hij telt zodra de bedrijven hem gaan uitlezen.
Is "User-Agent: *" met "Disallow: /" genoeg?
Nee. Volgens het concept geldt de algemene groep niet als trainingsvoorkeur. U hebt een aparte groep met __usage_ai-training nodig.
Verdwijnt mijn content uit bestaande AI-modellen?
Nee. Het signaal geldt alleen voor toekomstige training.
Is dit al een officiële standaard?
Nee. Het is een individueel concept dat op 30 oktober 2026 bij de IETF is ingediend en nog niet is goedgekeurd.