Yapay zeka donanımının en çok takip edilen karnesi MLPerf Inference'ın yeni turu açıklandı. Sektörün bağımsız ölçüm konsorsiyumu MLCommons, 16 Eylül'de v6.1 sonuçlarını yayımladı. Bu turun en dikkat çekici yanı, NVIDIA'nın yeni nesil veri merkezi sistemi Vera Rubin NVL72'nin ilk kez hakem denetiminden geçmiş rakamlarla ortaya çıkması. AMD ise şimdiye kadar bu testlere sokulan en büyük sistemle katıldı.
MLPerf Inference, eğitilmiş bir yapay zeka modelinin kullanıcı sorularına ne kadar hızlı cevap verdiğini, yani "çıkarım" (inference) performansını ölçüyor. ChatGPT gibi bir hizmetin maliyetini ve hızını belirleyen şey tam olarak bu. Bu yüzden çip üreticileri bu tabloda iyi görünmek için ciddi mühendislik harcıyor.
Bu turda neler öne çıktı?
MLCommons'a göre v6.1, katılım rekoru kırdı: 30 kuruluş, veri merkezi ve uç cihaz kategorilerinde toplam 486 sonuç gönderdi. Altı kuruluş ilk kez katıldı. Testlere iki yeni başlık eklendi:
- Uçtan uca RAG testi: Bir soruyu yanıtlamak için önce belgelerde arama yapıp sonra cevap üreten çok adımlı sistemleri ölçüyor.
- Uç cihazda ajan testi: Tek kullanıcılı bir cihazda, konuşma geçmişini hatırlayarak çok turlu işler yapan yapay zeka ajanlarının performansına bakıyor.
İlerleme hızı da çarpıcı. Bir yıl önceki v5.1 turuyla karşılaştırıldığında, DeepSeek-R1 modelinde hızlandırıcı başına en iyi sonuç 5,7 kat arttı. Görsel-dil modellerinde ise yalnızca altı ayda yaklaşık 3 kat iyileşme görüldü. Bu kazancın bir kısmı yeni donanımdan, önemli bir kısmı ise yazılım optimizasyonlarından geliyor.
Vera Rubin NVL72: İlk rakamlar
NVIDIA'nın 72 GPU'lu raf ölçeğindeki yeni sistemi Vera Rubin NVL72, "önizleme" kategorisinde yer aldı. Bu, ürünün henüz ticari olarak yaygın satışta olmadığı, bir sonraki tura kadar piyasaya çıkması beklenen donanımlar için kullanılan bir kategori. Sonuçları NVIDIA ve bulut sağlayıcısı Nebius gönderdi.
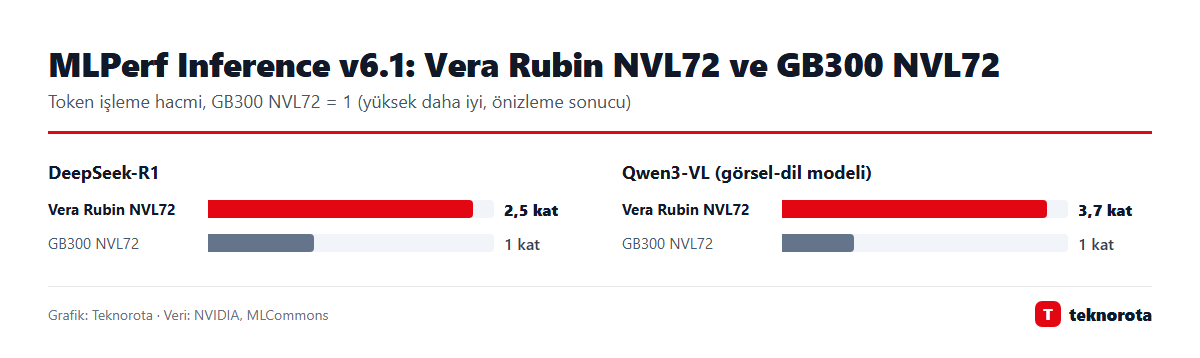
NVIDIA'nın verilerine göre Vera Rubin NVL72, bugünün en güçlü Blackwell sistemi olan GB300 NVL72'ye kıyasla DeepSeek-R1'de 2,5 kata, Qwen3-VL görsel-dil modelinde ise 3,7 kata kadar daha yüksek token işleme hacmine ulaştı. Şirket ayrıca mevcut GB300 sistemlerinde yalnızca yazılım güncellemeleriyle bir önceki tura göre 1,6 kata varan kazanç elde ettiğini ve dört rafı (288 GPU) birbirine bağladığında yüzde 99 ölçekleme verimliliğine ulaştığını açıkladı.
| Öne çıkan sonuç | Sistem | Değer |
|---|---|---|
| DeepSeek-R1, GB300'e göre | Vera Rubin NVL72 | 2,5 kata kadar |
| Qwen3-VL, GB300'e göre | Vera Rubin NVL72 | 3,7 kata kadar |
| gpt-oss-120b, çevrim dışı | 512× AMD MI355X (Crusoe) | 5,75 milyon token/sn |
| DeepSeek-R1, çevrim dışı | 512× AMD MI355X (Crusoe) | 2,9 milyon token/sn |
| Uç cihaz ajan testi | AMD Ryzen AI Max+ 395 | yaklaşık 20 token/sn |
Oranlar üreticilerin kendi karşılaştırmalarıdır; token değerleri MLPerf sonuçlarından derlenmiştir.
AMD: 512 GPU'luk rekor küme
AMD cephesinde en büyük haber, ilk kez katılan bulut şirketi Crusoe'nun 512 adet Instinct MI355X GPU'dan oluşan kümesi. Bu, MLPerf Inference tarihinde gönderilen en büyük sistem. Küme, OpenAI'ın açık modeli gpt-oss-120b'de saniyede 5,75 milyon token işledi.
AMD ayrıca ilk kez PCIe kart biçimindeki Instinct MI350P'yi yarıştırdı. Bu kart, büyük raf sistemleri yerine mevcut sunuculara takılabilen daha erişilebilir bir seçenek olarak konumlanıyor. Aynı donanımda yalnızca ROCm yazılım güncellemesiyle yüzde 28 ile 38 arasında performans artışı elde edildiği de raporlandı.
Turun ilginç denemelerinden biri de karma sistemler oldu. Cisco, sekiz NVIDIA H200 ile sekiz AMD MI350X'i aynı ağ üzerinde birlikte çalıştırdı. Dell ve MangoBoost ise biri Kore'de, diğeri ABD'de bulunan iki GPU grubunu Pasifik Okyanusu'nun iki yakasından tek sistem gibi çalıştırarak yüzde 97 ölçekleme verimliliği gösterdi.
Masaüstü ve uç cihazlar
Yeni ajan testinde, AMD'nin dizüstü ve mini PC'lerde kullanılan Ryzen AI Max+ 395 işlemcisi yaklaşık saniyede 20 token üretti. Intel ise 32 GB belleğe sahip iş istasyonu kartı Arc Pro B70'i ilk kez listeye soktu; dört kartlı bir sistemde gpt-oss-120b sonuçları önceki tura göre yüzde 27 ile 36 arasında iyileşti.
Bu ne anlama geliyor?
MLPerf sonuçları doğrudan bir satın alma rehberi değil; her şirket kendi güçlü olduğu testleri seçerek katılıyor ve karşılaştırmalar çoğu zaman aynı koşullarda yapılmıyor. Yine de tablonun genel mesajı net: Yapay zeka çıkarımının maliyeti hızla düşüyor. Bir yılda hızlandırıcı başına 5,7 katlık artış, aynı donanım yatırımıyla çok daha fazla kullanıcıya hizmet verilebileceği anlamına geliyor.
Son kullanıcı için bunun yansıması, yapay zeka hizmetlerinin daha hızlı cevap vermesi ve fiyatların uzun vadede baskı altında kalması. Bu hafta GPT-6 Sol ve Luna ile Claude Opus 5.5 gibi yeni modellerin art arda gelmesi, arka planda bu donanım yarışının ne kadar kritik olduğunu da gösteriyor.
Arka plan
NVIDIA, Vera Rubin platformunu Blackwell'in halefi olarak konumlandırıyor ve sistemlerin önümüzdeki aylarda büyük bulut sağlayıcılarına ulaşması bekleniyor. AMD ise MI355X ile NVIDIA'nın payını zorluyor ve tam raf çözümü Helios ile rekabeti bir üst seviyeye taşımaya hazırlanıyor. Bir sonraki MLPerf turunda Vera Rubin'in önizleme etiketinden kurtulup kurtulmayacağı ve AMD'nin yeni nesil raf sistemleriyle nasıl bir karşılık vereceği merak konusu.