Anthropic, 22 Eylül akşamı (Türkiye saatiyle 19.30 civarı) yeni yapay zeka modeli Claude Opus 5.5'i yayınladı. Claude 5.5 ailesinin ilk üyesi olan model, şirketin açıklamasına göre çoğu görevde en üst modeli Claude Fable 5.1 ile aynı seviyede sonuç veriyor, ancak Opus 5'ten yaklaşık yüzde 40 daha düşük maliyetle çalışıyor. Ailenin diğer üyeleri Sonnet 5.5 ve Haiku 5.5'in önümüzdeki haftalarda gelmesi planlanıyor.
Peki yeni model neyi farklı yapıyor ve fiyat indirimi gerçekte ne kadar tasarruf demek? Önce değişikliklere bakalım.
Neler değişti?
Anthropic'in paylaştığı verilerde öne çıkan başlıklar şunlar:
- Hız: Çıktı üretimi Opus 5'e göre yüzde 30'dan fazla hızlı.
- Daha az adım: Aynı işi daha az araç çağrısı ve daha az token harcayarak bitiriyor.
- Kodlama: Terminal-Bench 4.0'da %66,4 skor (Opus 5: %52,3). Kod incelemede bilinen hataların %72'sini yakalıyor (Opus 5: %56).
- Bilgisayar kullanımı: OSWorld 2.0'da %81,8 (Opus 5: %74,0).
- Yazım: Şirket, modelin daha sade ve daha az jargonlu yazdığını, önemli bilgiyi öne aldığını vurguluyor.
- Düşünme seviyeleri: Varsayılan ayar "orta" (medium). Geliştiriciler düşük, yüksek, çok yüksek (xhigh) ve maksimum seviyeler arasında seçim yapabiliyor.
Model API'de claude-opus-5-5 adıyla çağrılıyor. Abonelik kullanıcıları için ise ilginç bir yenilik var: Beş saatlik kullanım limitlerinin sıfırlanma hakkı biriktirilip ihtiyaç duyulan anda kullanılabiliyor.
Rakiplerle karşılaştırma: Benchmark sonuçları
Aşağıdaki grafikteki tüm rakamlar şirketin kendi ölçümleri; Anthropic'in duyuru sayfasındaki resmi tablodan derlendi. Bağımsız doğrulamalar henüz sınırlı.
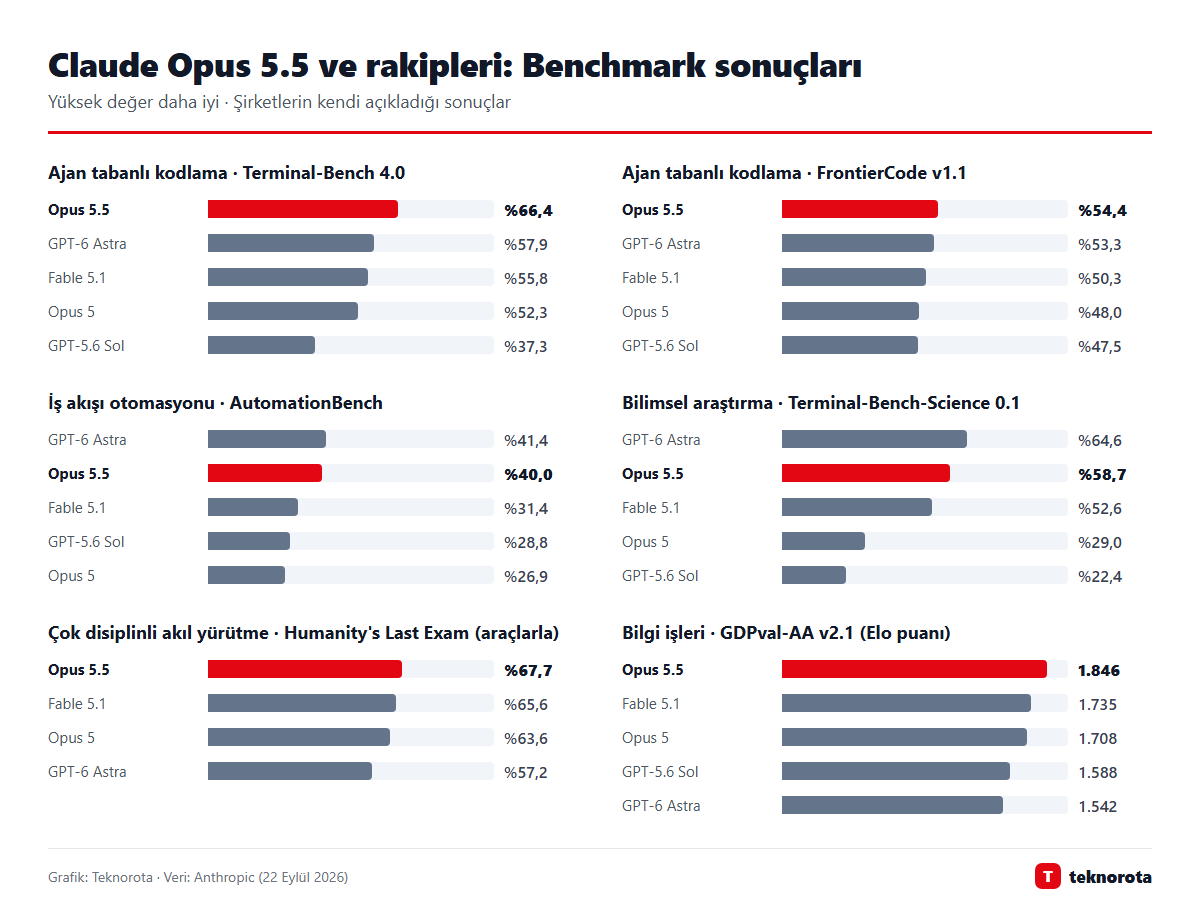
Grafikten çıkan sonuç şu: Opus 5.5, ajan tabanlı kodlamada (Terminal-Bench 4.0, FrontierCode) ve bilgi işlerinde (GDPval-AA) hem şirketin kendi Fable 5.1 modelini hem de OpenAI'ın en güçlü modeli GPT-6 Astra'yı geride bırakıyor. Buna karşın bilimsel araştırma testi Terminal-Bench-Science'ta (%64,6'ya %58,7) ve iş akışı otomasyonunu ölçen AutomationBench'te (%41,4'e %40,0) Astra hâlâ önde. Anthropic ayrıca CursorBench 4.0'da %57,8 skor paylaştı (Opus 5: %46,6).
Bağımsız kuruluş Artificial Analysis de X'teki paylaşımında Opus 5.5'in kendi "Intelligence Index" sıralamasında ilk sıraya yerleştiğini duyurdu.
Gerçek işlerde ne yapabiliyor?
Anthropic, rakamların yanında erken erişim müşterilerinden örnekler de paylaştı. Bunlar, modelin nerelerde işe yarayabileceğine dair somut bir fikir veriyor:
- Büyük kod tabanları: 200 bin satırlık bir kod tabanının güvenlik ve hata denetimi 3 saatte tamamlandı; aynı iş Opus 5 ile 20 saati aşmıştı.
- Kod taşıma: 680 bin satırlık bir taşıma (migration) projesi bir günden kısa sürede bitti.
- Uzun süreli görevler: Hukuk yazılımı şirketi Clio, modelin 18 saat gözetimsiz çalıştığı bir görevde çok az düzeltme gerektiğini aktarıyor.
- Maliyet: Finans şirketi Optiver, ajan tabanlı kodlamada yüzde 40-50 maliyet düşüşü gördüğünü söylüyor.
Erken test eden şirketler arasında GitHub, Spotify, Lovable, Deloitte, LexisNexis ve Thomson Reuters gibi isimler var. Bu örnekler şirketlerin kendi deneyimleri; her iş yükünde aynı sonucun alınacağı anlamına gelmiyor.
Fiyat karşılaştırması
| 1 milyon token | Opus 5 | Opus 5.5 |
|---|---|---|
| Girdi | 5 dolar | 4 dolar |
| Çıktı | 25 dolar | 20 dolar |
| Önbelleğe yazma | 6,25 dolar | 5 dolar |
| Önbellekten okuma | 0,50 dolar | 0,20 dolar |
Birim fiyatlar yüzde 20 düşerken, modelin görevleri daha az token ile bitirmesi sayesinde toplam tasarrufun yüzde 40'a ulaştığı belirtiliyor. Önbellekten okuma fiyatındaki yüzde 60'lık indirim, aynı uzun belgeyi ya da kod tabanını tekrar tekrar modele veren uygulamalar için özellikle önemli. 2,5 kata varan hız sunan "fast mode" seçeneği ise 8 dolar girdi, 40 dolar çıktı fiyatıyla sunuluyor.
Kimler kullanabilir?
Opus 5.5; claude.ai üzerinde Pro, Max, Team ve Enterprise planlarında, geliştiriciler için Claude API'de ve Amazon Web Services, Google Cloud ile Microsoft Azure üzerinden kullanılabiliyor. Ücretli planlarda beş saatlik kullanım limitleri de artırıldı. Kurumsal müşteriler için verilerin saklanmadığı (zero data retention) seçenek de mevcut.
Güvenlik ve hizalama
Anthropic, modelin otomatik davranış denetiminde şimdiye kadar test ettiği en iyi sonucu aldığını söylüyor. Yayından önce bağımsız değerlendirme kuruluşu METR de modeli inceledi. Öne çıkan diğer notlar:
- İstem enjeksiyonu (prompt injection): Kodlama, araç kullanımı, bilgisayar kullanımı ve web gezintisinde Opus 5'e eşit ya da daha dayanıklı; Gray Swan ölçümünde saldırı başarı oranı Fable 5.1 ile birlikte en düşük seviyede.
- Sınır aşma girişimleri: Modelin izin verilen alanın dışına çıkma girişimleri Opus 5'e göre yüzde 85 azaldı; görülen vakalar düşük önem düzeyinde ve model tarafından kendiliğinden bildirildi.
- Hassas alanlar: Siber güvenlik ve biyoloji gibi konularda Fable 5.1 düzeyinde koruma önlemleri uygulanıyor. İleri düzey kullanımlar Siber Doğrulama ve Yaşam Bilimleri Doğrulama programlarıyla onaylı kurumlara açılıyor.
- Test farkındalığı: Şirket, modelin çoğu zaman değerlendirildiğinden şüphelendiğini ve bunun ölçümleri zorlaştırdığını açıkça not etmiş.
Arka plan: Yarış fiyata döndü
Anthropic, en yetenekli modeli Fable 5.1'in yanında Opus, Sonnet ve Haiku serileriyle farklı bütçelere hitap ediyor. Opus 5.5 bu dengeyi değiştiriyor: Şirketin iddiasına göre Fable sınıfı performansı, önceki Opus'tan da düşük bir fiyatla sunuyor. Zamanlama tesadüf değil: Aynı akşam, yaklaşık bir buçuk saat sonra OpenAI da GPT-6 Sol ve Luna modellerini benzer bir "yarı fiyatına" mesajıyla duyurdu. OpenAI'ın en güçlü modeli GPT-6 Astra ise eylül başında yayınlanmıştı. Üç büyük sohbet asistanının genel farklarını merak ediyorsanız ChatGPT, Gemini ve Claude karşılaştırması rehberimize göz atabilirsiniz.
Türkiye için ne anlama geliyor?
Türkiye için ayrı bir fiyat veya kısıtlama açıklanmadı; claude.ai abonelik ücretlerinde de bir değişiklik duyurulmadı. API faturaları dolar bazlı olduğu için, Claude'u ürünlerine entegre eden Türk yazılım ekipleri ve girişimler tasarrufu doğrudan hissedecek. Mevcut Opus 5 entegrasyonlarında model adını claude-opus-5-5 olarak değiştirmek genellikle yeterli; ancak çıktıların üslubu değiştiği için canlıya almadan önce kendi senaryolarınızda denemek iyi olur. Modelin Türkçe performansına dair ayrı bir ölçüm paylaşılmadı.
Model seçimi yapan ekipler için bir not: Opus 5.5 milyon token başına 4/20 dolarla, aynı akşam çıkan GPT-6 Sol'un (2/10 dolar) iki katı fiyatta. Anthropic'in iddiası, modelin işi daha az adımda ve daha az token ile bitirerek bu farkı kapattığı yönünde. Hangisinin daha ekonomik olduğu, sadece birim fiyata değil, kendi iş yükünüzde görev başına harcanan toplam token miktarına bağlı. Bu yüzden iki modeli aynı örnek görevlerle deneyip toplam faturayı karşılaştırmak en sağlıklı yol.
Sık sorulan sorular
Claude Opus 5.5 ücretsiz mi?
Hayır. Duyuruya göre model Pro, Max, Team ve Enterprise gibi ücretli planlarda ve API'de sunuluyor. Ücretsiz planla ilgili bir açıklama yapılmadı.
Opus 5.5'in API fiyatı ne kadar?
Milyon token başına 4 dolar girdi ve 20 dolar çıktı. Önbellekten okuma 0,20 dolar, "fast mode" ise 8/40 dolar.
Opus 5.5 mi daha güçlü, GPT-6 Astra mı?
Anthropic'in kendi ölçümlerine göre Opus 5.5 kodlama ve bilgi işlerinde önde, bilimsel araştırma ve iş akışı otomasyonunda ise Astra biraz önde. Bağımsız karşılaştırmalar henüz sınırlı.
Sonnet 5.5 ve Haiku 5.5 ne zaman çıkacak?
Anthropic yalnızca "önümüzdeki haftalarda" dedi; kesin bir tarih vermedi.