"Yerli yapay zeka" ifadesi Türkiye'de birbirinden çok farklı üç şeyi anlatmak için kullanılıyor. Birincisi, Türkçe için sıfırdan eğitilmiş dil modelleri. İkincisi, dünyada yayımlanmış açık modellerin Türkçeye uyarlanmış sürümleri. Üçüncüsü de bu modelleri Türkiye'deki donanımda çalıştıran altyapılar. Bu rehberde Eylül 2026 itibarıyla kaynakla doğrulayabildiğimiz projeleri bu ayrıma göre sıraladık. Her biri için kimin geliştirdiğini, açık olup olmadığını ve bugün nasıl erişilebildiğini yazdık. Doğrulayamadığımız bilgileri tahminle doldurmadık, "açıklanmadı" diye belirttik.
Kısa özet: Hangi proje ne durumda?
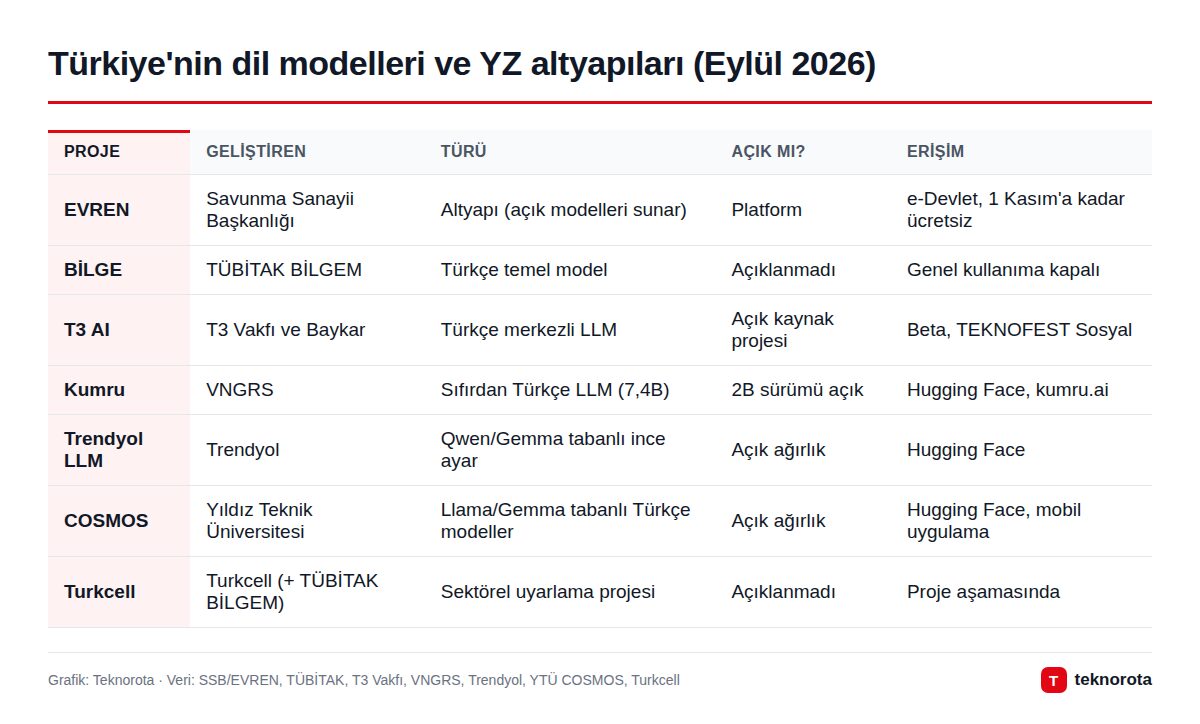
| Proje | Geliştiren | Ne tür? | Ağırlıklar açık mı? | Bugün erişim |
|---|---|---|---|---|
| EVREN | Savunma Sanayii Başkanlığı | Çıkarım ve eğitim altyapısı | Sunduğu modeller açık ağırlıklı | e-Devlet ile, LLM 1 Kasım 2026'ya kadar ücretsiz |
| BİLGE | TÜBİTAK BİLGEM | Türkçe temel model | Açıklanmadı | Genel kullanıma kapalı |
| T3 AI | T3 Vakfı ve Baykar | Türkçe merkezli dil modeli | Açık kaynak projesi olarak tanımlanıyor | 2025'te TEKNOFEST Sosyal'de beta |
| Kumru | VNGRS | Sıfırdan Türkçe eğitilmiş model | 2B sürümü açık (Apache 2.0) | Hugging Face, kumru.ai demosu |
| Trendyol LLM | Trendyol | Açık modellerin Türkçe ince ayarı | Açık (Apache 2.0 ve diğerleri) | Hugging Face |
| COSMOS | Yıldız Teknik Üniversitesi | Açık modellerin Türkçe uyarlaması | Açık ağırlıklı | Hugging Face, mobil ve masaüstü uygulama |
| Turkcell | Turkcell, TÜBİTAK BİLGEM ile | Sektörel uyarlama projesi | Açıklanmadı | Proje aşamasında |
EVREN: Türkiye'de çalışan açık modeller
Geliştiren: Cumhurbaşkanlığı Savunma Sanayii Başkanlığı (SSB), Savunma Sanayii Yapay Zeka Platformu (SSYZ) kapsamında.
EVREN bir dil modeli değil, bir yapay zeka platformu. Veri etiketleme, model eğitimi, görüntü çıkarımı ve model paylaşımı gibi işleri tek web arayüzünde topluyor. Listemize girmesinin sebebi LLM çıkarım katmanı. Bu katman GLM-5.3, DeepSeek-V4-Flash, Qwen ve Gemma 4 gibi açık ağırlıklı modelleri OpenAI uyumlu tek bir API ile sunuyor. Resmi altyapı sayfasına göre arkada 8 düğüme dağılmış 64 adet NVIDIA H200 GPU bulunuyor. Platform, istem ve yanıtların Türkiye'de işlendiğini ve yurt dışına aktarılmadığını beyan ediyor.
- Erişim: e-Devlet ile giriş. Her yeni hesaba 1.000 kredi (CR) tanımlanıyor.
- Ücret: Resmi sayfaya göre LLM kullanımı test süreci boyunca, 1 Kasım 2026'ya kadar ücretsiz. Sonraki fiyatlandırma açıklanmadı.
- Öne çıkan: Günlük 10 milyon token kota, bir milyon token'a kadar bağlam penceresi sunan model seçeneği ve modeli kendisi seçen otomatik yönlendirici.
Ayrıntılar için EVREN haberimize bakabilirsiniz.
BİLGE: TÜBİTAK'ın Türkçe temel modeli
Geliştiren: TÜBİTAK BİLGEM, Sanayi ve Teknoloji Bakanlığı koordinasyonunda.
BİLGE, 13 Haziran 2026'daki Türkiye Yapay Zeka Zirvesi'nde ilk kez kamuoyuna gösterildi. TÜBİTAK'ın zirve sonrasındaki açıklamasına göre model henüz genel kullanıma açık değil. Kurum, internette BİLGE adıyla sunulan uygulamaların resmi hizmet olmadığı konusunda da uyarıda bulundu. Erişim ve kullanım koşullarının yalnızca TÜBİTAK ile Bakanlığın resmi kanallarından duyurulacağı belirtildi.
- Açık mı? Ağırlıkların yayımlanıp yayımlanmayacağı açıklanmadı.
- Parametre sayısı ve eğitim verisi: Resmi olarak açıklanmadı.
- Neden önemli? Sanayi ve Teknoloji Bakanlığı, "Türkçe Büyük Dil Temel Modeli Sektörel Uyarlama" çağrısıyla şirketlerin Türkçe temel modeli kendi sektörlerine uyarlamasını destekliyor. Aşağıda değineceğimiz Turkcell projesi de bu çağrı kapsamında.
T3 AI: T3 Vakfı ve Baykar'ın dil modeli
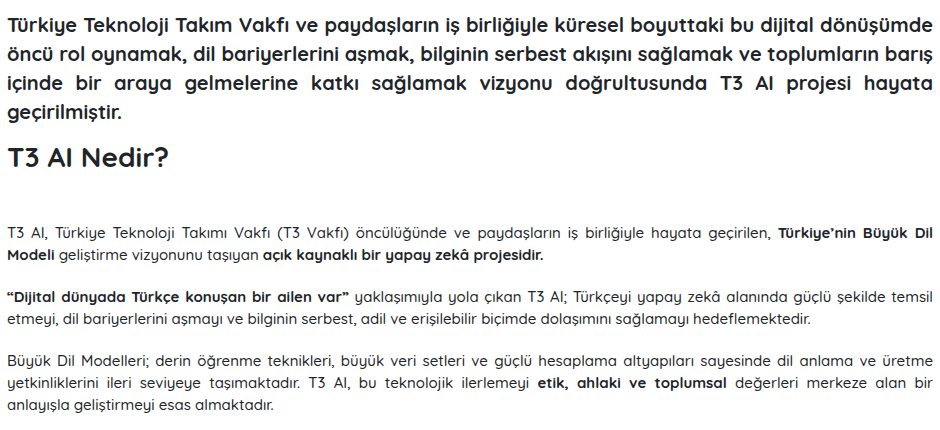
Geliştiren: Türkiye Teknoloji Takımı Vakfı (T3 Vakfı), Baykar iş birliğiyle.
T3 Vakfı projeyi Mart 2024'te "T3 AI'LE" adıyla duyurdu ve gönüllü başvurusu açtı. Anadolu Ajansı'nın 11 Temmuz 2025 tarihli haberine göre model, beta sürümüyle TEKNOFEST Sosyal platformunda kullanıma sunuldu. O dönemde 67 ilden 1.792 gönüllünün projeye katıldığı aktarılmıştı. Açık beta ilk günün sonunda yeterli veri toplandığı gerekçesiyle durduruldu ve modelin güncellenip geri döneceği bildirildi.
- Açık mı? Vakfın sayfası T3 AI'ı "açık kaynaklı bir yapay zeka projesi" olarak tanımlıyor. Ancak model ağırlıklarının nereden indirilebileceğine dair bir bağlantı sayfada yok.
- Öne çıkan: Türkçe merkezli olması, Türk cumhuriyetlerindeki metinleri anlamayı hedeflemesi ve gönüllü topluluk modeliyle geliştirilmesi.
- Açıklanmayanlar: Parametre sayısı, güncel sürüm ve genel erişim tarihi.
Kumru: Türkçe için sıfırdan eğitilen model
Geliştiren: İstanbul merkezli yazılım şirketi VNGRS.
Kumru bu listede, mevcut bir yabancı modelin üzerine inşa edilmeyip Türkçe metinlerle sıfırdan ön eğitim gördüğü doğrulanabilen model. Ekim 2025'te duyurulan 7,4 milyar parametreli sürüm, 500 GB temizlenmiş metin üzerinde toplam 300 milyar token ile yaklaşık 45 gün boyunca H100 ve H200 GPU'larda eğitildi. Model, Türkçeye özel 50 binden fazla parçalık bir kelime dağarcığı (tokenizer) kullanıyor.
- Açık mı? Küçük sürüm Kumru-2B, temel ve talimatla eğitilmiş varyantlarıyla birlikte Hugging Face'te Apache 2.0 lisansıyla yayımlandı. 7,4B sürüm kumru.ai üzerindeki demo ile deneniyor.
- Öne çıkan: Özetleme, belge işleme ve kurum içi soru-cevap senaryoları. Webrazzi'nin aktardığına göre model 16 GB belleğe sahip ekran kartlarında çalışabiliyor.
- Sınır: 8.192 token'lık bağlam penceresi, dünya modellerine göre kısa.
Trendyol LLM: E-ticaret için Türkçe ince ayar
Geliştiren: Trendyol.
Trendyol'un Hugging Face sayfasında birden fazla model yayımlanmış durumda. Bunlar sıfırdan eğitilmiş değil, açık modellerin Türkçe ve e-ticaret verisiyle ince ayarlanmış sürümleri.
- Trendyol-LLM-8B-T1: Qwen3-8B tabanlı, 8 milyar parametreli. Türkçe "düşünerek" yanıt verebiliyor ve 32 bin token bağlamı destekliyor. Apache 2.0 lisanslı olduğu için ticari kullanıma açık.
- Trendyol-LLM-Asure-12B: Gemma 3-12B tabanlı, metin ve görseli birlikte işleyen çok modlu bir model. Operasyonel görevlerde talimat takibine odaklanıyor.
- Öne çıkan: Moda, elektronik gibi e-ticaret kategorilerinin sözcük dağarcığına hâkim olması.
COSMOS: Yıldız Teknik Üniversitesi'nin açık modelleri
Geliştiren: Yıldız Teknik Üniversitesi Bilgisayar Mühendisliği bünyesindeki COSMOS araştırma grubu (Prof. Dr. Mehmet Fatih Amasyalı).
COSMOS, Türkçe doğal dil işleme alanında en düzenli model yayımlayan akademik ekiplerden biri. Hugging Face'teki ytu-ce-cosmos hesabında şunlar bulunuyor:
- Turkish-Llama-8b: Llama 3 8B'nin 30 GB Türkçe veriyle tüm parametreleri üzerinden ince ayarlanmış sürümü.
- Turkish-Gemma-9b-v0.1 (CosmosGemma): Gemma 2 9B tabanlı. Sürekli ön eğitim, ince ayar ve tercih optimizasyonuyla geliştirildi, Mayıs 2025'te yayımlandı. Gemma lisansına tabi.
- Diğerleri: Türkçe GPT-2, arama için Türkçe gömme (embedding) modelleri ve görsel-dil modeli Turkish-LLaVA.
Grubun sitesine göre modeller masaüstü ve mobil uygulama üzerinden de denenebiliyor.
Turkcell: Kendi modeli değil, sektörel uyarlama
Geliştiren: Turkcell, TÜBİTAK BİLGEM ile birlikte.
Turkcell'in kamuya açık, kendi adıyla yayımlanmış bir büyük dil modeli bulunmuyor. Şirketin 10 Temmuz 2026 tarihli basın bülteni, "doğru işe doğru model" yaklaşımıyla birden fazla modeli bir arada kullandığını ve Türkçe yeteneklere odaklandığını anlatıyor. Aynı bültende Google Cloud ile Türkiye'de bir bulut bölgesi kurma ortaklığı da yer alıyor. CEO Ali Taha Koç'un paylaşımına göre Turkcell, TÜBİTAK BİLGEM ile hazırladığı çok modlu, Türkçe dil modeli tabanlı bir çağrı merkezi asistanı projesiyle Bakanlığın sektörel uyarlama çağrısından destek aldı. Projenin ne zaman hizmete gireceği açıklanmadı.
Hangisini kullanabilirim?
İhtiyaca göre kısa bir yol haritası:
- Hazır API ve veri gizliliği arıyorsanız: Bu listedeki projeler arasında büyük modellere hazır API ile, yurt içinden ve şimdilik ücretsiz erişim sunan tek seçenek EVREN. Yalnız e-Devlet hesabı gerekiyor ve ücretsiz dönemin 1 Kasım 2026'da bittiğini unutmayın.
- Modeli kendi sunucunuzda çalıştırmak istiyorsanız: Trendyol-LLM-8B-T1, Kumru-2B ya da COSMOS'un 8-9 milyar parametreli modelleri, tek bir güçlü ekran kartına sığan açık seçenekler. Lisanslar farklı olduğu için ticari kullanım öncesinde model kartını mutlaka okuyun.
- Sadece denemek istiyorsanız: Kurulum gerektirmeyen en kolay yollar kumru.ai demosu ve COSMOS'un mobil uygulaması.
Genel amaçlı asistanlarla kıyaslamak isterseniz ChatGPT, Gemini ve Claude karşılaştırmamıza göz atın.
Sık sorulan sorular
Türkiye'nin kendi büyük dil modeli var mı?
Sıfırdan Türkçe eğitildiği doğrulanabilen modeller var; en somut örnek VNGRS'in Kumru'su. Devlet destekli temel model BİLGE Haziran 2026'da tanıtıldı ama henüz genel kullanıma açılmadı.
EVREN yerli bir dil modeli mi?
Hayır. EVREN, GLM, DeepSeek, Qwen ve Gemma gibi yabancı kaynaklı açık modelleri Türkiye'deki H200 GPU kümesinde çalıştıran bir altyapı. "Yerli" olan kısım donanım ve verinin işlendiği yer.
BİLGE'yi nereden kullanabilirim?
TÜBİTAK'ın açıklamasına göre şu an hiçbir yerden kullanılamıyor. BİLGE adını taşıyan uygulamalar resmi değil. Erişim duyurusu TÜBİTAK ve Sanayi ve Teknoloji Bakanlığı kanallarından yapılacak.
Hangi Türkçe modeller ticari kullanıma açık?
Model kartlarına göre Trendyol-LLM-8B-T1 ve Kumru-2B Apache 2.0 lisanslı. COSMOS'un Gemma tabanlı modeli Google'ın Gemma lisansına tabi. Kullanmadan önce her modelin lisansını ayrıca kontrol edin.
T3 AI açık kaynak mı?
T3 Vakfı projeyi açık kaynaklı olarak tanımlıyor. Ancak indirilebilir model ağırlıkları ve parametre sayısı resmi sayfada paylaşılmıyor.
Sonuç
Türkiye'de yerli yapay zeka 2026'da iki kolda ilerliyor. Bir yanda EVREN gibi dünya modellerini yurt içinde çalıştıran altyapılar, öbür yanda BİLGE ve Kumru gibi Türkçeyi temelden öğrenen modeller var. Bugün geliştiricinin elinde en çok seçenek açık ağırlıklı uyarlamalarda ve EVREN'in ücretsiz API'sinde. BİLGE'nin erişime açılması ve EVREN'in 1 Kasım sonrası fiyatlandırması, önümüzdeki ayların en çok takip edilecek iki gelişmesi olacak.