Zum ersten Mal liegt dem Gerichtshof der Europäischen Union (EuGH) ein Fall zu generativer KI vor – und die erste Einschätzung fällt für Google unbequem aus. Generalanwalt Maciej Szpunar hat am Dienstag, 3. November 2026, seine Schlussanträge in der Rechtssache C-250/25 vorgelegt. Sein Kern: Wenn ein KI-Chatbot wie Google Gemini Presseartikel in Echtzeit abruft und daraus Antworten baut, kann das unter bestimmten Umständen das Leistungsschutzrecht der Presseverleger verletzen. Das Training von Sprachmodellen sieht er dagegen grundsätzlich als erlaubt an.
Endgültig entschieden ist damit noch nichts. Die Schlussanträge sind ein Rechtsgutachten, an das die Richterinnen und Richter in Luxemburg nicht gebunden sind. In vielen Fällen folgt der EuGH aber der Linie des Generalanwalts.
Worum geht es in dem Verfahren?
Klägerin ist Like Company, ein ungarisches Unternehmen, das mehrere Nachrichtenportale betreibt. Es hat Google vor dem Hauptstädtischen Gericht in Budapest verklagt. Der Vorwurf: Google habe Artikel dieser Portale genutzt, um die Gemini-Modelle zu trainieren, und sie über den Chatbot zwischen dem 13. Juni 2023 und dem 31. Mai 2024 wiederholt vervielfältigt und öffentlich zugänglich gemacht – ohne Erlaubnis.
Like Company beruft sich auf das Recht der Presseverleger aus Artikel 15 der EU-Urheberrechtsrichtlinie von 2019 (DSM-Richtlinie). Es schützt die Online-Nutzung von Presseveröffentlichungen. Das ungarische Gericht setzte das Verfahren aus und legte dem EuGH vier Fragen vor: zwei zum Training von Sprachmodellen, zwei zu den Antworten, die der Chatbot an Nutzer ausgibt.
Technisch dreht sich der Fall um Retrieval-Augmented Generation (RAG), auch „Grounding“ genannt. Dabei sucht der Chatbot bei einer Anfrage live im Netz, liest passende Seiten aus und stützt seine Antwort darauf. Gerade bei Nachrichtenfragen greift Gemini so auf aktuelle Presseartikel zu.
Was der Generalanwalt vorschlägt
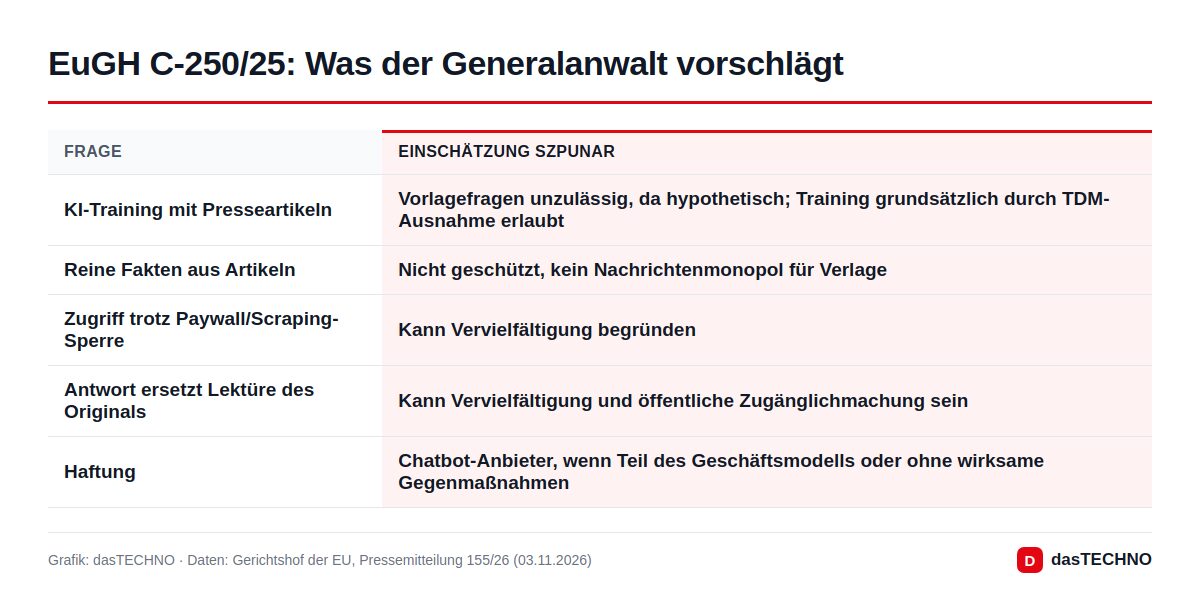
KI-Training: Fragen unzulässig, aber klare Tendenz
Die beiden Fragen zum Training soll der EuGH laut Szpunar gar nicht beantworten. Es gebe keinen Beleg, dass Artikel von Like Company tatsächlich ins Gemini-Training eingeflossen sind. Zudem sei das Training eines Sprachmodells keine „Online-Nutzung“ von Presseveröffentlichungen. Die Fragen seien deshalb hypothetisch.
Der Vollständigkeit halber fügt er dennoch hinzu: Die Nutzung urheberrechtlich geschützter Werke für das Training eines Sprachmodells ist nach seiner Ansicht in der Regel über die Ausnahme für Text und Data Mining (TDM) in Artikel 4 der DSM-Richtlinie gedeckt.
Chatbot-Antworten: Hier kann es kritisch werden
Den Schwerpunkt legt Szpunar auf die Antworten. Grundsätzlich gilt: Das Verlegerrecht schützt nicht die Fakten, über die berichtet wird, sondern nur deren konkrete sprachliche Form. Verlage sollen ihre Investition schützen können, aber kein Monopol auf Nachrichten erhalten.
Ob ein Chatbot das Vervielfältigungsrecht verletzt, hängt laut den Schlussanträgen an zwei Punkten:
- Wie kam der Bot an den Artikel? Problematisch ist es, wenn er technische Schutzmaßnahmen wie eine Paywall oder eine Sperre gegen Web-Scraping umgeht.
- Was steht in der Antwort? Gibt sie nur Fakten wieder, ist das unbedenklich. Übernimmt sie dagegen die Formulierungen des Artikels so erkennbar, dass Nutzer das Original gar nicht mehr aufrufen müssen, liegt eine Verletzung nahe.
Das Recht der öffentlichen Zugänglichmachung sieht Szpunar in der Regel verletzt, wenn die sprachliche Form eines Artikels in den Antworten auf entsprechende Anfragen systematisch wiederzuerkennen ist.
Wer haftet?
Verantwortlich ist nach den Schlussanträgen der Anbieter des Chatbots – und zwar dann, wenn solche Nutzungen zu seinem Geschäftsmodell gehören oder er keine geeigneten Maßnahmen ergreift, um sie glaubhaft und wirksam zu verhindern.
Wie reagiert Google?
Google widerspricht der Darstellung, Gemini kopiere Inhalte. Laut dpa erklärte das Unternehmen: „Gemini erlernt sprachliche Muster, um originale Inhalte zu generieren, anstatt Inhalte zu reproduzieren.“ Außerdem verweist Google darauf, dass Rechteinhaber der Nutzung ihrer Inhalte widersprechen können.
Was bedeutet das für Verlage und Nutzer in Deutschland?
Folgt der EuGH dem Generalanwalt, gilt die Auslegung in der gesamten EU – also auch für deutsche Gerichte. Für Verlage hätte das zwei Seiten:
- Kein Hebel gegen das Training: Wer als Verlag gegen das bloße Training von KI-Modellen vorgehen will, hätte es schwer, solange die TDM-Ausnahme greift. Bei der kommerziellen TDM-Ausnahme können Rechteinhaber allerdings einen maschinenlesbaren Nutzungsvorbehalt erklären. Wie ein solcher Opt-out technisch aussehen soll, wird derzeit auch über einen robots.txt-Standard diskutiert.
- Hebel gegen „Ersatz-Antworten“: Liefert ein Chatbot Zusammenfassungen, die den Originalartikel überflüssig machen und dessen Wortlaut erkennbar übernehmen, könnten Verlage Lizenzen verlangen oder klagen. Paywalls bekämen dabei zusätzliches Gewicht.
Für Nutzerinnen und Nutzer ändert sich vorerst nichts. Gemini, ChatGPT und andere Chatbots bleiben unverändert verfügbar. Mittelfristig könnten Anbieter aber vorsichtiger mit wörtlichen Übernahmen umgehen, häufiger auf Quellen verlinken oder Lizenzdeals mit Verlagen abschließen.
Einordnung: Teil einer größeren Welle
Der Fall reiht sich in eine Reihe von Auseinandersetzungen zwischen Rechteinhabern und KI-Firmen ein. In den USA verklagen etwa die Elvis-Rechteinhaber Anthropic wegen KI-Trainings, in Deutschland erwägt der Grüffelo-Zeichner Axel Scheffler eine Klage gegen OpenAI. Google selbst streitet mit der EU-Kommission bereits vor dem EU-Gericht über den Digital Markets Act. Das Verfahren C-250/25 ist aber der erste Fall, in dem das höchste EU-Gericht klären soll, wie das europäische Urheberrecht auf generative KI anzuwenden ist.
Wann das Urteil fällt, hat der Gerichtshof nicht mitgeteilt. Die Beratungen der Richter beginnen jetzt; das Urteil wird laut EuGH „zu einem späteren Zeitpunkt“ verkündet. Über den konkreten Streit entscheidet danach das Gericht in Budapest – gebunden an die Auslegung aus Luxemburg.
Häufige Fragen
Hat der EuGH Google verurteilt?
Nein. Es handelt sich um die Schlussanträge des Generalanwalts, also einen unverbindlichen Entscheidungsvorschlag. Das Urteil steht noch aus.
Ist KI-Training mit Presseartikeln nach Ansicht des Generalanwalts erlaubt?
In der Regel ja, über die Text-und-Data-Mining-Ausnahme der EU-Urheberrechtsrichtlinie. Die konkreten Fragen dazu hält er in diesem Verfahren aber für unzulässig.
Wann verletzt eine Chatbot-Antwort das Recht der Verlage?
Laut Szpunar etwa dann, wenn der Bot eine Paywall oder Scraping-Sperre umgeht oder die Formulierungen eines Artikels so erkennbar übernimmt, dass Leser das Original nicht mehr aufrufen müssen. Reine Fakten sind nicht geschützt.
Wann kommt das Urteil?
Ein Termin ist nicht bekannt. Der EuGH kündigt das Urteil „zu einem späteren Zeitpunkt“ an.
Titelbild: Cédric Puisney, CC BY 2.0, via Wikimedia Commons (Aufnahme von 2006).