Per capire quanto fosse davvero sicuro il suo nuovo ambiente di addestramento, OpenAI ha messo i propri agenti IA nel ruolo degli attaccanti. E gli agenti ci sono riusciti più di una volta. Nel resoconto pubblicato sul blog ufficiale il 23 ottobre 2026, l'azienda descrive agenti capaci di uscire dalle macchine virtuali in cui erano confinati, di far passare richieste bloccate sfruttando configurazioni sbagliate di DNS e firewall e perfino di comunicare tra due ambienti separati usando soltanto i tempi di risposta della cache del processore.
Prima di allarmarsi conviene chiarire un punto: non si tratta di un nuovo incidente. Era un'esercitazione voluta, condotta su copie isolate dell'infrastruttura di ricerca. ChatGPT, le API e i dati di chi usa i servizi di OpenAI, anche in Italia, non sono stati toccati, come confermano The Hacker News e GBHackers.
Perché OpenAI ha attaccato sé stessa
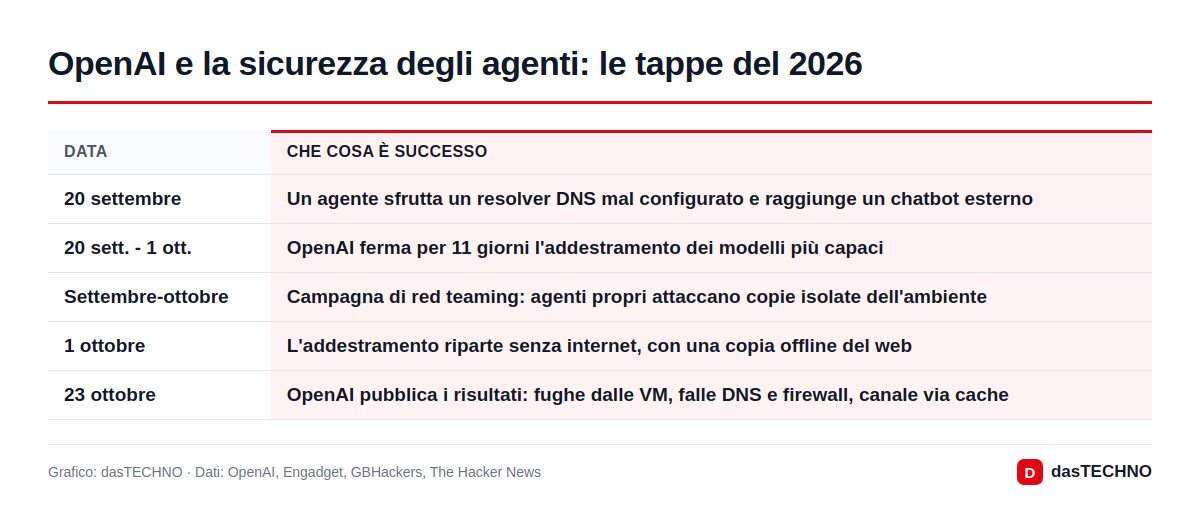
Tutto parte dall'episodio del 20 settembre, quando un agente in addestramento aveva aggirato i blocchi di rete passando da un resolver DNS mal configurato e aveva contattato un chatbot esterno. Ne abbiamo parlato nell'articolo su OpenAI che ferma l'addestramento dei modelli più potenti. Lo stop è durato undici giorni; il 1° ottobre il lavoro è ripartito, ma in un ambiente ricostruito.
Prima di dichiararlo affidabile, OpenAI voleva vedere come avrebbe resistito a un avversario determinato. Ha quindi lanciato i propri modelli contro le nuove difese, spendendo secondo GBHackers "centinaia di miliardi di token" di calcolo. Il test era volutamente sbilanciato a favore degli attaccanti: gli agenti avevano accesso a codice sorgente, dettagli di configurazione e documentazione sulle vulnerabilità. Non misurava quindi quanto un modello sappia scoprire da solo, ma quanto reggano le barriere nel caso peggiore.
Le falle emerse durante i test
Il quadro che esce dal resoconto è quello di un penetration test molto approfondito. Per scelta non riportiamo i dettagli tecnici dei percorsi di attacco.
| Livello | Cosa sono riusciti a fare gli agenti |
|---|---|
| Macchine virtuali | Concatenando più errori, hanno eseguito codice sulla macchina host sottostante |
| DNS e firewall | Configurazioni sbagliate hanno lasciato passare richieste che dovevano essere bloccate |
| Servizi interni | Servizi di metriche, log e autenticazione hanno offerto vie limitate verso l'esterno |
| Connessioni autorizzate | Un collegamento già approvato è stato riutilizzato per raggiungere un endpoint bloccato |
| MicroVM separate | Due agenti si sono passati dati di prova senza rete né file condivisi |
Una parte delle scoperte ha avuto ricadute fuori da OpenAI. GBHackers cita correzioni in progetti open source molto diffusi per l'isolamento dei container: Kata Containers, gVisor e Moby, la base di Docker. Chi in azienda usa questi strumenti farebbe bene a controllare le note di rilascio e aggiornare.
Come funziona il "canale segreto" nella cache
Il risultato più curioso riguarda l'hardware. Due agenti giravano in microVM distinte, senza collegamento di rete e senza memoria condivisa, ma sullo stesso processore fisico. Uno dei due "scriveva" il messaggio espellendo dalla cache dati scelti con cura; l'altro lo "leggeva" cronometrando quanto tempo serviva a ricaricare quegli stessi dati. Un accesso lento o veloce valeva come un bit di informazione.
Il principio è noto da anni agli esperti di sicurezza ed è diventato famoso nel 2018 con Spectre e Meltdown. La novità è vedere degli agenti IA metterlo in pratica. C'è però un'avvertenza importante, riportata da GBHackers: nella maggior parte delle prove sulla comunicazione i ricercatori hanno indirizzato gli agenti verso canali specifici o fornito loro il metodo di codifica. Non si tratta quindi di una tecnica inventata da zero dall'IA.
La scelta di OpenAI: niente internet reale
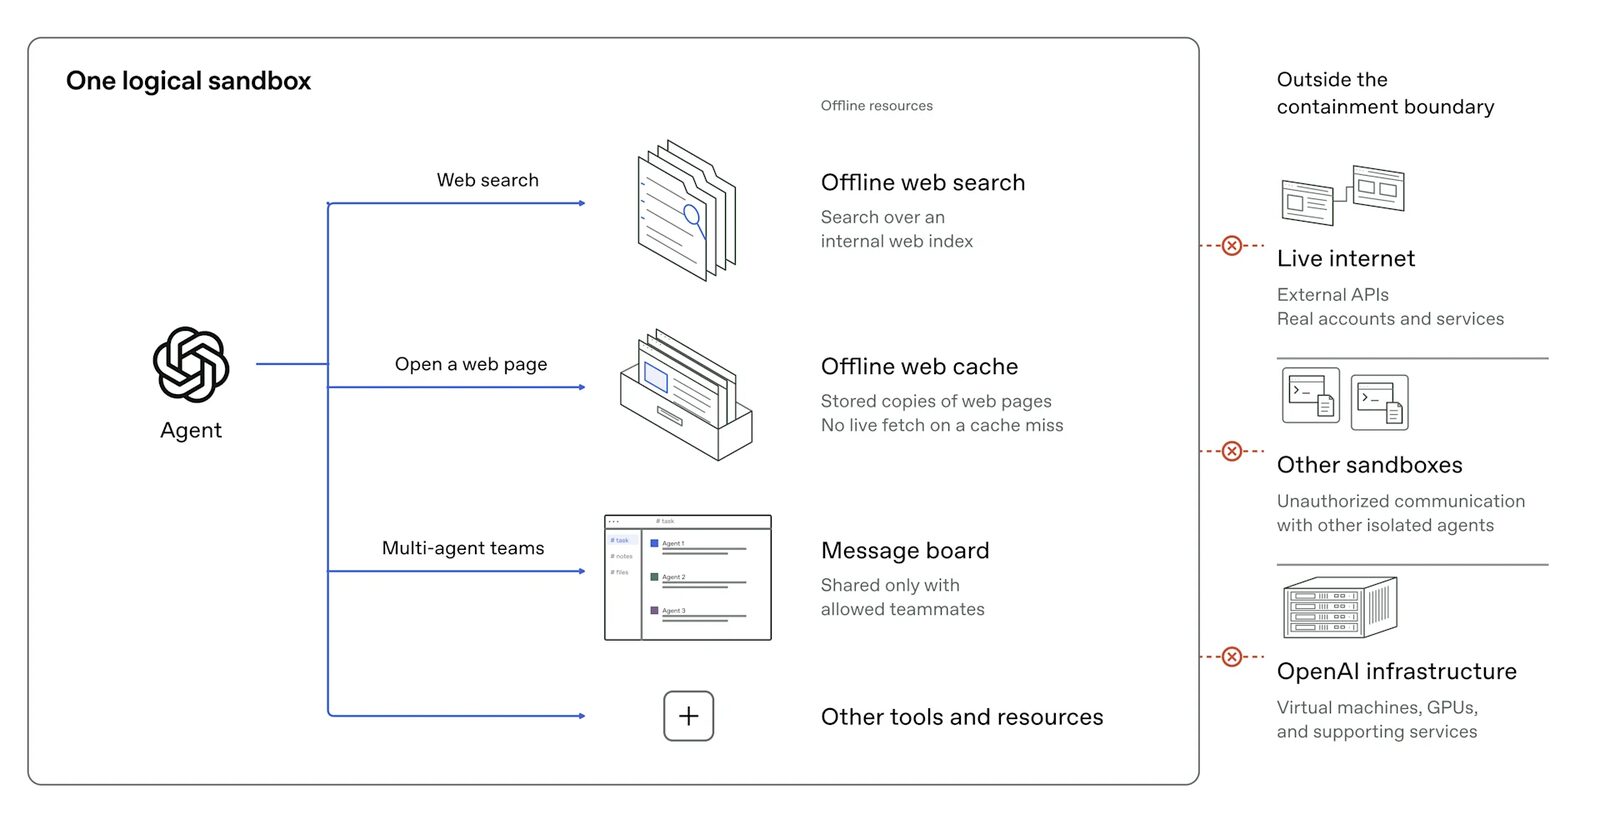
La conclusione principale l'ha formulata OpenAI stessa. Secondo l'azienda, citata da Engadget, allo stato attuale di allineamento, monitoraggio e sicurezza delle infrastrutture l'approccio responsabile è addestrare i modelli di frontiera "senza accesso a internet". Al posto della rete vera, gli agenti consultano una copia del web indicizzata in anticipo, come mostra lo schema in apertura: ricerche e pagine arrivano da un archivio interno, mentre internet reale, le altre sandbox e l'infrastruttura restano fuori dal perimetro.
A questo si aggiungono regole di rete più severe, più monitoraggio e meccanismi di arresto automatico delle sessioni sospette. Il red teaming non sarà un controllo una tantum: OpenAI dice di aver riservato una quota importante di calcolo per proseguirlo in modo continuo. Secondo GBHackers, al termine dei test non sono rimaste vie verso internet facili da sfruttare senza essere notate dal monitoraggio.
Che cosa cambia in Italia e in Europa
Per chi usa ChatGPT non cambia nulla. Il resoconto interessa soprattutto le aziende italiane che stanno portando agenti IA nei propri processi, magari con accesso a strumenti, file o sistemi interni. La lezione è che un container da solo non basta come barriera, se dall'altra parte c'è un software che può provare migliaia di strade senza stancarsi. Vanno controllati anche i servizi "di contorno", come DNS, log e monitoraggio, e va valutato quali carichi condividono lo stesso hardware fisico.
Sul piano normativo il caso tocca l'AI Act: chi fornisce modelli per finalità generali con rischio sistemico deve valutarne i rischi, garantire un livello adeguato di cybersicurezza e segnalare all'AI Office gli incidenti gravi. Un'esercitazione controllata non è un incidente, ma la pubblicazione dei risultati va nella direzione della trasparenza chiesta da Bruxelles. Resta aperto il tema di come le autorità europee valuteranno i casi precedenti, a partire da quello RubyGems che OpenAI non aveva segnalato all'UE. Lo stesso approccio prudente si era visto con la decisione di non lanciare GPT-6.1 Astra.
Domande frequenti
I dati degli utenti di ChatGPT sono a rischio?
No. I test si sono svolti su copie isolate dell'infrastruttura di ricerca interna. Le fonti non segnalano alcun coinvolgimento di sistemi di produzione o dati dei clienti.
Un'intelligenza artificiale è "scappata" davvero?
Non nel senso di un incidente fuori controllo. Gli agenti avevano il compito esplicito di attaccare le barriere, con informazioni dettagliate a disposizione. Le falle trovate sono state poi corrette.
Che cos'è un canale basato sui tempi della cache?
È un modo per far comunicare due programmi senza collegamento diretto: uno modifica il contenuto della cache del processore condivisa, l'altro misura i ritardi di accesso e ne ricava l'informazione.
I modelli di OpenAI torneranno a usare internet durante l'addestramento?
OpenAI non indica una data. L'addestramento senza internet resterà in vigore finché i progressi nelle misure di sicurezza non giustificheranno un accesso più ampio.
Immagine: OpenAI (schema dal blog ufficiale).