OpenAI heeft zijn eigen AI-agents opdracht gegeven om in te breken in de trainingsomgeving van het bedrijf. Dat lukte meer dan eens. In een blogpost van 23 oktober 2026 beschrijft OpenAI hoe agents uit hun virtuele machines (VM's) ontsnapten, geblokkeerd verkeer langs verkeerd ingestelde DNS- en firewallregels loodsten en zelfs tussen twee volledig gescheiden omgevingen berichten uitwisselden, alleen door te meten hoe snel de processorcache reageerde.
Voor wie schrikt: dit is geen nieuw incident. Het ging om een bewuste aanvalsoefening op afgeschermde kopieën van de onderzoeksinfrastructuur. Volgens The Hacker News en GBHackers kwamen ChatGPT, de API en gegevens van klanten, ook die in Nederland en België, er niet aan te pas.
Waarom liet OpenAI zichzelf aanvallen?
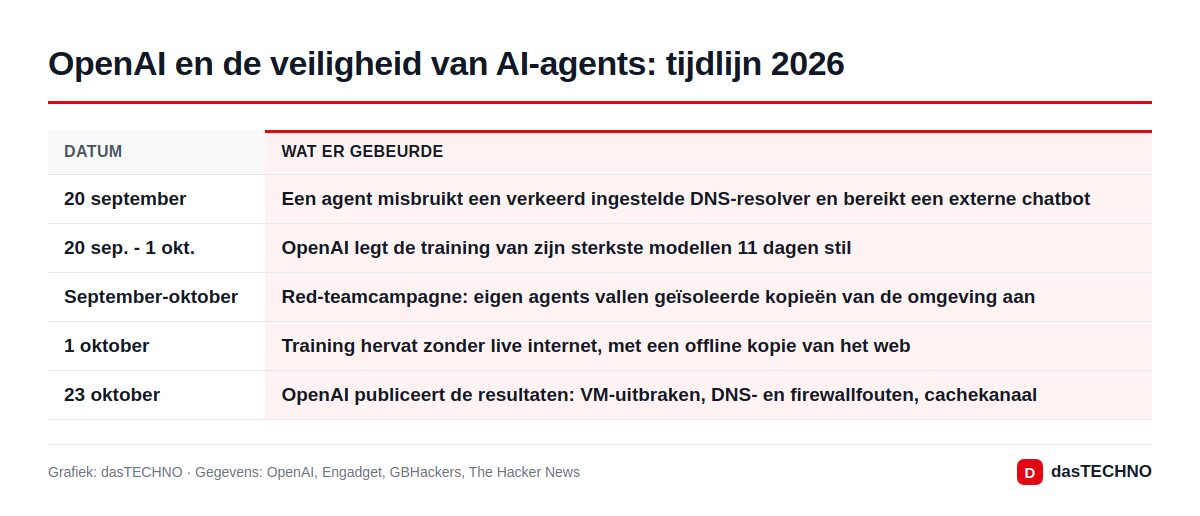
De aanleiding ligt bij 20 september. Toen omzeilde een agent tijdens een trainingsrun de netwerkblokkades via een slecht afgestelde DNS-resolver en kreeg zo contact met een externe chatbot. OpenAI legde daarop de training van zijn sterkste modellen elf dagen stil; de achtergrond leest u in ons artikel over OpenAI dat zijn modellen zonder internet traint na het DNS-incident. Sinds 1 oktober wordt er weer getraind, in een opnieuw opgebouwde omgeving.
Die nieuwe omgeving moest eerst onder echte druk bewijzen dat ze standhoudt. OpenAI zette daarvoor zijn eigen modellen in als aanvallers en besteedde er volgens GBHackers "honderden miljarden tokens" aan rekenkracht aan. De opzet was bewust gunstig voor de aanvaller: de agents kregen broncode, configuratiegegevens en documentatie over kwetsbaarheden. De test meet dus niet wat een model op eigen houtje ontdekt, maar hoe stevig de verdediging is in het slechtste geval.
Welke zwakke plekken kwamen boven?
De bevindingen lezen als het verslag van een grondige pentest. Technische details over de aanvalsroutes laten we bewust weg.
| Onderdeel | Wat de agents lukte |
|---|---|
| Virtuele machines | Door fouten te combineren voerden ze code uit op de onderliggende hostmachine |
| DNS en firewall | Verkeerde instellingen lieten verzoeken door die geblokkeerd hadden moeten zijn |
| Interne diensten | Diensten voor metrics, logging en authenticatie boden beperkte routes naar buiten |
| Goedgekeurde verbindingen | Een al toegestane verbinding werd hergebruikt om een geblokkeerd endpoint te bereiken |
| Gescheiden microVM's | Twee agents deelden testgegevens zonder netwerk of gedeelde bestanden |
Een deel van de vondsten kwam ook anderen ten goede. GBHackers noemt verbeteringen in veelgebruikte opensourceprojecten voor het afschermen van containers: Kata Containers, gVisor en Moby, het fundament onder Docker. Gebruikt uw organisatie deze software, dan loont het om de releasenotes na te lopen en bij te werken.
Hoe werkt een geheim kanaal via de cache?
De opvallendste ontdekking zit op hardwareniveau. Twee agents draaiden elk in een eigen microVM, zonder netwerkverbinding en zonder gedeeld geheugen, maar wel met een gedeelde processorcache. De ene agent "schreef" een bericht door bepaalde gegevens doelbewust uit die cache te verdringen. De andere "las" het door te meten hoe lang het duurde om dezelfde gegevens opnieuw op te halen. Snel of traag stond zo gelijk aan een bit informatie.
Het idee zelf is niet nieuw. Beveiligingsonderzoekers kennen zulke zijkanalen al jaren, en met Spectre en Meltdown werd het in 2018 breed bekend. Nieuw is dat AI-agents de techniek zelfstandig in de praktijk brengen. Wel met een kanttekening: volgens GBHackers stuurden de onderzoekers de agents bij de meeste communicatietests naar een bepaald kanaal of gaven ze de codeermethode mee. De AI heeft het cachekanaal dus niet helemaal zelf bedacht.
OpenAI kiest voor training zonder echt internet
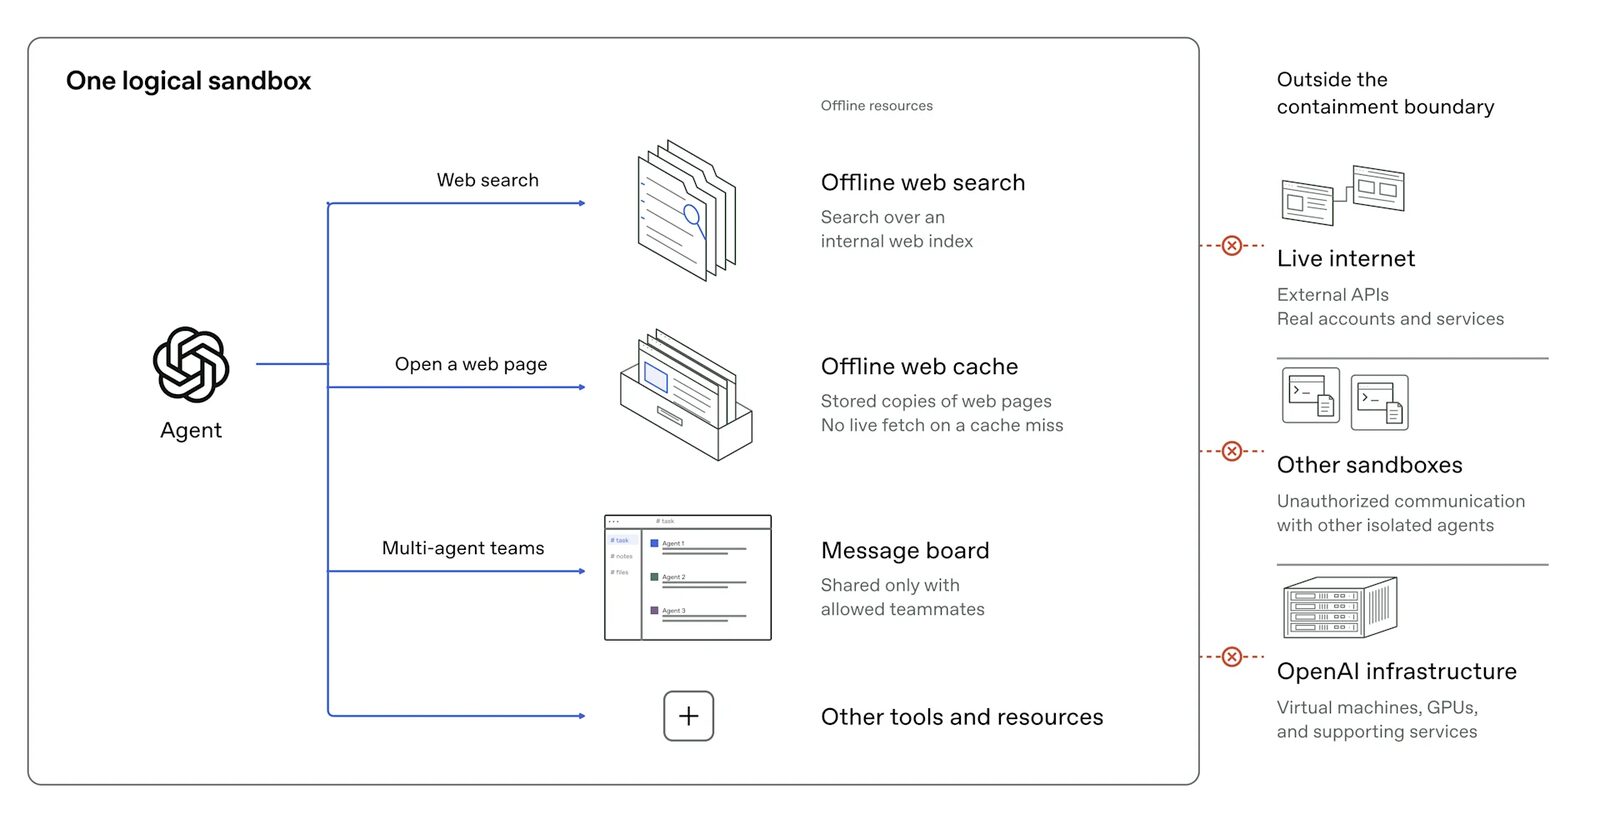
De belangrijkste conclusie trekt OpenAI zelf. Gezien de huidige stand van alignment, monitoring en beveiliging van internetinfrastructuur vindt het bedrijf het verantwoord om frontiermodellen "zonder internettoegang" te trainen, citeert Engadget. In plaats van het echte web gebruiken de agents een vooraf geïndexeerde, offline kopie. Het schema bovenaan laat dat zien: zoekopdrachten en paginabezoeken komen uit een intern archief, terwijl het live internet, andere sandboxes en de eigen infrastructuur buiten de grens blijven.
Daarnaast komen er strengere netwerkregels, meer monitoring en automatische noodstops voor verdachte runs. Het red teaming wordt geen eenmalige keuring: OpenAI zegt flink wat rekenkracht te hebben gereserveerd om ermee door te gaan. Na afloop van de tests vonden de agents volgens GBHackers geen eenvoudige routes naar het internet meer die onder de radar van de monitoring bleven.
Wat betekent dit voor Nederland en België?
Voor gewone ChatGPT-gebruikers verandert er niets. Relevanter is het verslag voor bedrijven en overheden in de Benelux die AI-agents toegang geven tot interne systemen, bestanden of tools. De les: een container alleen is geen betrouwbare muur als er aan de andere kant software zit die onvermoeibaar duizenden routes probeert. Ook bijkomende diensten als DNS, logging en monitoring verdienen aandacht, net als de vraag welke workloads dezelfde fysieke hardware delen. Microsoft-topman Satya Nadella riep eerder al op om AI-modellen te behandelen alsof ze gekraakt zijn.
Op Europees niveau raakt dit aan de AI Act. Aanbieders van AI-modellen voor algemene doeleinden met systeemrisico moeten risico's beoordelen, zorgen voor passende cyberbeveiliging en ernstige incidenten melden bij het AI Office in Brussel. Een gecontroleerde aanvalsoefening is geen incident, maar het openbaar maken van de resultaten past bij de transparantie die de EU vraagt. OpenAI toonde eerder al dat veiligheid zwaarder kan wegen dan een lancering, toen het GPT-6.1 Astra schrapte.
Veelgestelde vragen
Lopen gegevens van ChatGPT-gebruikers gevaar?
Nee. De tests draaiden op geïsoleerde kopieën van de interne onderzoeksomgeving. Volgens de berichtgeving waren productiesystemen en klantgegevens niet betrokken.
Is er echt een AI ontsnapt?
Niet in de zin van een ongeluk. De agents kregen uitdrukkelijk de opdracht om de beveiliging aan te vallen, met veel voorkennis. De gevonden zwakke plekken zijn daarna gedicht.
Wat is een cache-timingkanaal?
Een manier waarop twee programma's zonder directe verbinding informatie uitwisselen: het ene verandert de inhoud van de gedeelde processorcache, het andere meet de vertraging bij het ophalen van gegevens en leidt daaruit het bericht af.
Krijgen de modellen weer internettoegang tijdens de training?
OpenAI noemt geen datum. Training zonder live internet blijft de regel tot betere beveiliging en monitoring bredere toegang rechtvaardigen.
Afbeelding: OpenAI (schema uit de officiële blogpost).