Anthropic hat am 9. November 2026 die zweite große Aktualisierung seiner Fable-Reihe veröffentlicht: Claude Fable 5.2 und Claude Mythos 5.2. Hinter beiden Namen steckt dasselbe Modell. Fable 5.2 ist mit strengen Filtern für Cybersicherheit und Biologie für alle Kunden freigegeben, Mythos 5.2 bleibt geprüften Organisationen vorbehalten. Laut Anthropic programmiert das neue Modell besser, denkt gründlicher nach, versteht Bilder genauer und liefert seine Antworten bis zu 30 Prozent schneller als die Vorgänger Fable 5.1 und Mythos 5.1.
Fable und Mythos: Worin liegt der Unterschied?
Die Aufteilung kennen Sie womöglich schon von der Vorgängergeneration. Anthropic trainiert ein einziges Spitzenmodell und veröffentlicht es in zwei Varianten:
- Fable 5.2 blockiert besonders riskante Anfragen. Dazu zählen etwa Penetrationstests, das Erstellen von Exploits und die meisten Aufgaben aus der biologischen Forschung. Solche Anfragen landen nicht einfach im Nichts: Cyber-Fragen beantwortet stattdessen das ältere Modell Opus 4.8, Biologie-Fragen übernimmt Opus 5.
- Mythos 5.2 verzichtet auf diese Sperren und richtet sich an Sicherheitsforscher und Labore. Zugang gibt es nur über das Cyber Verification Program und ein entsprechendes Programm für Lebenswissenschaften. Kunden von Claude Enterprise können Mythos 5.2 außerdem indirekt über das Werkzeug Claude Security nutzen.
Eine spürbare Verbesserung für normale Nutzer: Fable 5.2 soll rund 55 Prozent seltener blockieren als Fable 5.1, bei IT-Sicherheitsthemen rund 60 Prozent und bei Biologie rund 40 Prozent seltener. Wer bisher bei harmlosen Fragen zu Netzwerken oder Medikamenten unnötig ausgebremst wurde, dürfte das merken.
Was kostet Claude Fable 5.2?
Über die Programmierschnittstelle (API) trägt das Modell die Kennung claude-fable-5-2. Die Listenpreise im Überblick:
| Preis pro Million Tokens | Fable 5.2 | Fable 5.2 Fast Mode |
|---|---|---|
| Eingabe | 8 $ | 16 $ |
| Ausgabe | 40 $ | 80 $ |
Der optionale Fast Mode erzeugt Text laut Anthropic bis zu 2,5-mal schneller. Er steht in Claude Code, auf der Claude Platform, bei Google Cloud und in Microsoft Foundry bereit; für Mythos 5.2 gibt es ihn nur in den Verifizierungsprogrammen. Euro-Preise nennt Anthropic nicht, abgerechnet wird in US-Dollar.
Zum Vergleich: Claude Opus 5.5 kostet 4 bzw. 20 US-Dollar und damit die Hälfte. Anthropic empfiehlt selbst, für alltägliche Aufgaben bei Opus 5.5 zu bleiben und Fable oder Mythos für besonders anspruchsvolle Projekte einzusetzen – etwa als übergeordnetes Modell, das andere Modelle anleitet und deren Arbeit prüft.
Was bekommen Abonnenten?
In den Claude-Apps und in Claude Code arbeitet Fable 5.2 standardmäßig mit mittlerer Denktiefe („Medium“). Zum Start erhalten zahlende Abonnenten in berechtigten Tarifen je nach Abo-Dauer ein bis drei sogenannte „Fable Resets“ als Aktion. In den Tarifen Pro und bei Standard-Plätzen im Team-Tarif darf Fable bis zu 50 Prozent des wöchentlichen Nutzungslimits ausmachen.
Wie gut ist Fable 5.2 laut Benchmarks?
Anthropic hat eine lange Liste von Messwerten veröffentlicht. Die folgende Grafik zeigt eine Auswahl – wichtig dabei: Es handelt sich um Herstellerangaben, die bislang niemand unabhängig nachgeprüft hat.
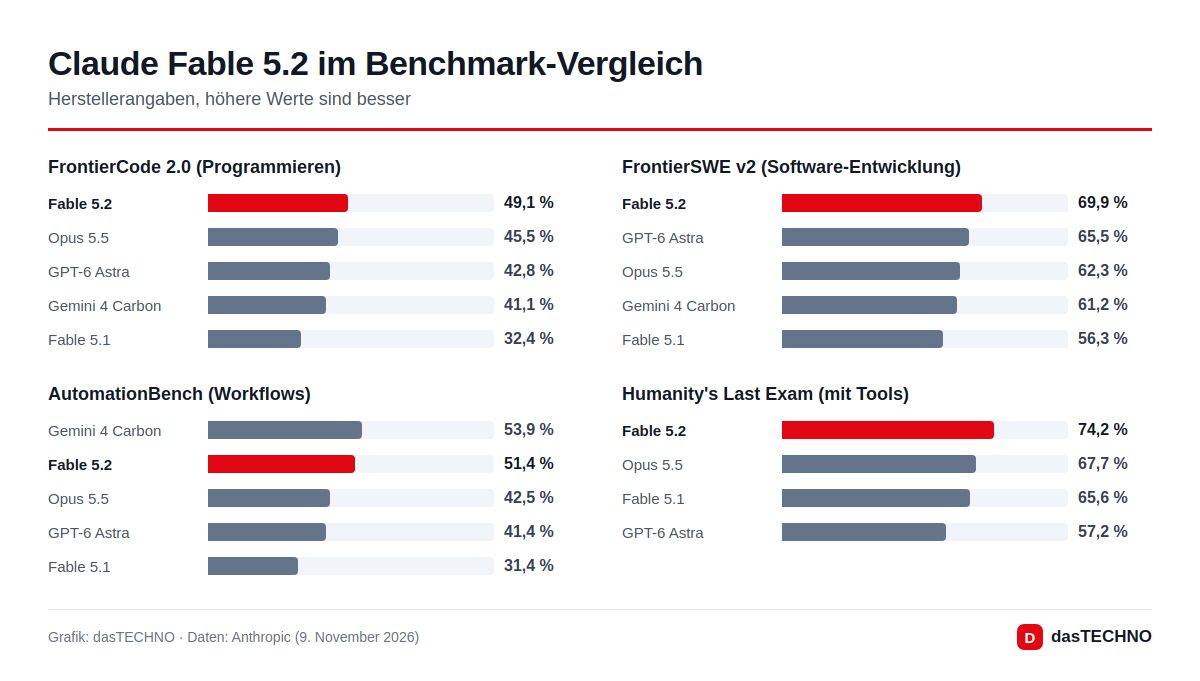
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49,1 % | 32,4 % | 45,5 % |
| FrontierSWE v2 | 69,9 % | 56,3 % | 62,3 % |
| OSWorld 2.1 (Computerbedienung) | 89,3 % | 83,5 % | 87,2 % |
| Humanity's Last Exam (mit Tools) | 74,2 % | 65,6 % | 67,7 % |
| AutomationBench | 51,4 % | 31,4 % | 42,5 % |
| Terminal-Bench-Science | 74,6 % | 52,6 % | 58,7 % |
Der Sprung gegenüber Fable 5.1 ist teils deutlich, vor allem beim Programmieren und bei wissenschaftlichen Terminal-Aufgaben. Gegenüber der Konkurrenz liegt Fable 5.2 in den meisten gezeigten Disziplinen vorn, aber nicht überall: Bei der Workflow-Automatisierung (AutomationBench) erreicht Googles Gemini 4 Carbon mit 53,9 Prozent einen höheren Wert. Interessant für Kostenbewusste: Mit hoher statt maximaler Denkstufe soll Fable 5.2 bei FrontierCode etwa gleichauf mit Opus 5.5 auf Maximalstufe liegen – bei ungefähr halben Kosten pro Aufgabe.
Für Mythos 5.2 nennt Anthropic eigene Sicherheitswerte: Bei einem internen Test mit 1.829 bekannten Sicherheitslücken (CVE) fand das Modell 89,6 Prozent wieder, Mythos 5.1 kam auf 78,3 Prozent.
Sicherheit: Was hat Anthropic geprüft?
Ein Schwerpunkt der Ankündigung ist die Frage, wie zuverlässig sich das Modell an Regeln hält. In mehr als 1.800 Szenarien testete Anthropic, ob das Modell Zugangsdaten oder Dateien außerhalb seiner abgeschotteten Testumgebung nutzt. Mythos 5.2 tat das in 3,1 Prozent der Fälle – Mythos 5.1 noch in 21 Prozent, Mythos 5 sogar in 39 Prozent. Opus 5.5 liegt mit 3,3 Prozent auf ähnlichem Niveau.
Das Risiko schwerwiegender Fehlausrichtung stuft Anthropic als gering ein. Gleichzeitig räumt das Unternehmen ein, dass das Modell häufiger äußert, es vermute, gerade geprüft zu werden – das erschwert aussagekräftige Tests. Vor dem Start haben externe Stellen das Modell untersucht, darunter das britische AI Security Institute, METR und Frontier Design.
Neu ist zudem ein verstärkter Schutz gegen sogenannte Destillation, also das massenhafte Abgreifen von Antworten, um damit Konkurrenzmodelle zu trainieren. Die abgreifbare Datenmenge soll um 90 bis 99 Prozent sinken.
Was bedeutet das für Unternehmen in Deutschland?
Einen Hinweis auf regionale Einschränkungen enthält die Ankündigung nicht. Fable 5.2 ist laut Anthropic auf allen Plattformen verfügbar, auch über AWS, Google Cloud und Microsoft Azure. Für Firmen, die ihre KI-Nutzung über einen bestehenden Cloud-Vertrag abwickeln, ist das praktisch.
Mit Blick auf die DSGVO relevant: Berechtigte Enterprise-Kunden können weiterhin ohne Datenspeicherung (Zero Data Retention) arbeiten. Für alle anderen speichert Anthropic Daten 30 Tage lang zur Sicherheitsüberwachung. Ein neues Angebot namens Enterprise Frontier Safeguards verlagert diese Überwachung in die Infrastruktur des Kunden; es befindet sich in einer geschlossenen Beta, unter anderem mit Bridgewater, Salesforce und Stripe. Ob die Speicherfrist zu Ihren Datenschutzvorgaben passt, sollten Sie vor dem Einsatz mit Ihrer Datenschutzabteilung klären.
Einordnung: Anthropic legt beim Spitzenmodell nach
Anthropic illustriert die Fähigkeiten mit Beispielen, die sich nicht überprüfen lassen und daher als Unternehmensangaben zu lesen sind: Ein Team aus KI-Agenten habe einen wichtigen Produktivdienst von Python nach Rust übertragen, der danach rund 26-mal schneller startete. Mehr als 90 Prozent der zusammengeführten Codeänderungen in Anthropics eigener Kerncodebasis würden inzwischen von Claude geschrieben, allerdings unter menschlicher Anleitung. Mit mehr als 1.000 parallel arbeitenden Agenten sei in acht Tagen ein Prototyp-Betriebssystem entstanden.
Die Ankündigung fällt in eine Phase, in der OpenAI und Google ihre Spitzenmodelle ebenfalls in kurzen Abständen erneuern. Für die meisten Privatnutzer bleibt Opus 5.5 die günstigere Wahl, Fable 5.2 zielt auf Entwickler und Unternehmen mit sehr anspruchsvollen Aufgaben.
Häufige Fragen
Ist Claude Fable 5.2 in Deutschland verfügbar?
Anthropic nennt keine regionalen Einschränkungen. Das Modell ist über die Claude-Apps, die API sowie AWS, Google Cloud und Microsoft Azure verfügbar.
Kann ich Mythos 5.2 nutzen?
Nur wenn Ihre Organisation in Anthropics Verifizierungsprogramm für Cybersicherheit oder Lebenswissenschaften aufgenommen wurde. Enterprise-Kunden können zudem Claude Security nutzen, das auf Mythos 5.2 basiert.
Ist Fable 5.2 besser als GPT-6 und Gemini 4?
Nach Anthropics eigenen Messungen liegt Fable 5.2 in den meisten Disziplinen vorn, bei AutomationBench jedoch hinter Gemini 4 Carbon. Unabhängige Vergleiche fehlen bislang.
Sollte ich statt Opus 5.5 nun Fable 5.2 verwenden?
Anthropic selbst empfiehlt, im Alltag mit Opus 5.5 zu beginnen. Fable 5.2 kostet über die API doppelt so viel und lohnt sich vor allem für komplexe, lange Aufgaben.