Google ha aggiornato la propria tecnologia di sintesi vocale con due nuovi modelli, Gemini 3.8 Flash TTS e la variante economica Flash-Lite TTS, annunciati il 23 settembre sul blog ufficiale The Keyword. Il titolo che ha fatto il giro del web è la clonazione di una voce con appena 30 secondi di registrazione. C'è però un dettaglio che in molti articoli manca: stando a Google, proprio questa funzione non è disponibile nello Spazio economico europeo, e quindi chi sviluppa dall'Italia non la trova in AI Studio. Il resto delle novità, invece, è accessibile.
Cosa fanno i nuovi modelli Gemini 3.8 TTS?
I due modelli trasformano un testo in parlato, ma puntano a usi diversi.
- Gemini 3.8 Flash TTS è pensato per il lavoro creativo: si può descrivere a parole la voce che si desidera ("un narratore anziano, calmo, con accento del sud") e il modello la genera da zero. Ogni battuta può ricevere indicazioni di regia su tono, ritmo, cambi di dialetto, sussurri, risate o sospiri.
- Gemini 3.8 Flash-Lite TTS è la versione orientata ai grandi volumi e ai costi contenuti: doppiaggio, audiolibri prodotti in serie, assistenti vocali che devono rispondere a molte persone contemporaneamente.
Entrambi possono gestire un dialogo tra due voci partendo da un unico copione e, secondo Google, mantengono la stessa voce coerente anche su ore di audio. Chi non vuole progettare una voce propria può scegliere in un catalogo di più di 2.000 voci predefinite. Il post parla di più di 100 lingue e varianti regionali; la scheda tecnica per sviluppatori di Flash TTS indica invece oltre 130 lingue con riconoscimento automatico. Tra gli esempi di varianti citati ci sono lo spagnolo messicano e il francese del Québec; l'italiano rientra tra le lingue supportate.
Per la qualità, Google si appoggia a valutazioni esterne: nel Voice Design Benchmark di Hume AI, Flash TTS ottiene 71,4 punti, primo posto, e guida anche la classifica sugli accenti con 60,8. Nell'indice di qualità complessiva della stessa società i due modelli occupano il primo e il secondo posto. Sono dati dichiarati dall'azienda e da un valutatore esterno; la nostra redazione non ha usato i modelli direttamente.
Clonazione della voce: come funziona e perché in Italia no
La clonazione, che Google chiama voice replication, richiede due registrazioni della stessa persona adulta: un campione di parlato naturale (la documentazione indica tra 10 e 30 secondi) e una frase di consenso letta dal titolare della voce, in cui dichiara di autorizzare Google a creare un modello sintetico. Se le due voci non corrispondono, il profilo non viene creato. Le voci salvate restano associate al progetto fino a un anno, con un massimo di 200 per progetto; in alternativa si può ottenere una chiave temporanea valida sette giorni.
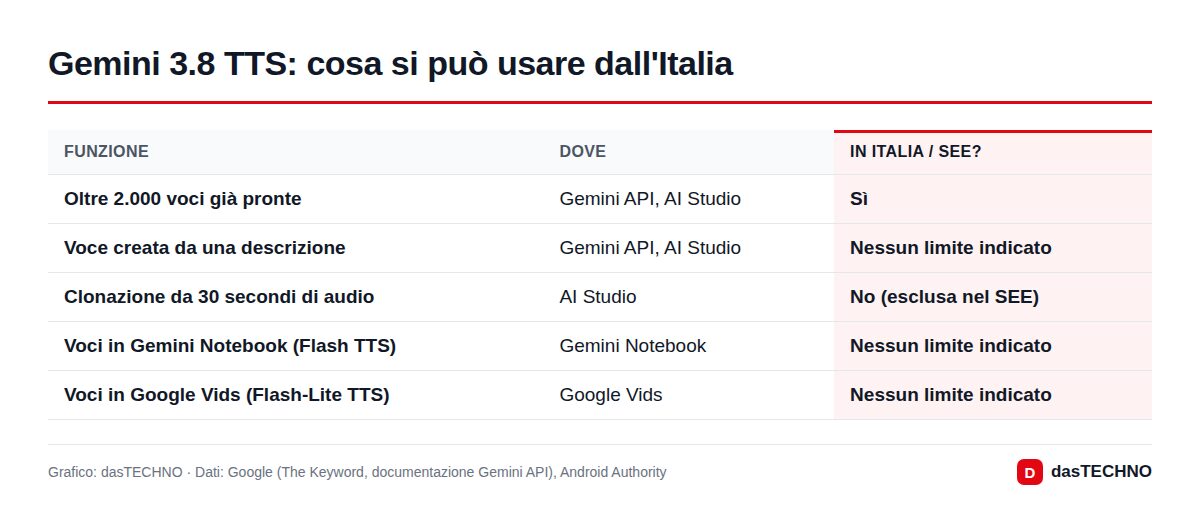
Il blog di Google è esplicito: la clonazione tramite AI Studio non è disponibile in Illinois, Texas, Spazio economico europeo, Regno Unito, Svizzera e India. L'azienda non spiega il motivo. Si può però notare che quasi tutte queste giurisdizioni hanno regole severe sui dati biometrici: in Europa la voce usata per identificare una persona rientra tra le categorie particolari di dati del GDPR, mentre Illinois e Texas hanno leggi statali specifiche sulla biometria. La documentazione della Gemini API, dal canto suo, non riporta limitazioni geografiche: al momento non è chiaro se l'esclusione valga anche per l'accesso diretto via API, e Google non lo ha precisato.
In pratica, dall'Italia si possono usare le voci predefinite, creare voci nuove partendo da una descrizione e sfruttare i modelli dentro i prodotti Google, ma non riprodurre la propria voce o quella di un collega.
Dove si trovano già i nuovi modelli
| Prodotto | Modello | Per chi |
|---|---|---|
| Gemini API e Google AI Studio | Flash TTS e Flash-Lite TTS | Sviluppatori, da subito |
| Gemini Notebook | Flash TTS | Tutti gli utenti |
| Google Vids | Flash-Lite TTS | Tutti gli utenti |
| Gemini Enterprise | Entrambi via API | "Prossimamente" |
Google non ha indicato prezzi nel post di lancio. Tra i partner che integrano i modelli figurano Figma, HeyGen, Wondercraft, LiveKit e Vercel. Il lancio arriva negli stessi giorni di Gemini 3.8 Live e degli avatar animati per le aziende: Google sta spingendo molto sull'audio e sulla voce come interfaccia.
Filigrane e regole: cosa cambia contro i deepfake vocali
Tutti gli audio generati ricevono SynthID, la filigrana invisibile di Google che resta nel file e permette di riconoscerlo come sintetico. Per le voci clonate l'azienda aggiunge le credenziali C2PA, uno standard aperto che registra l'origine di un contenuto.
Il contesto europeo spiega la prudenza. L'AI Act prevede obblighi di trasparenza per i contenuti generati artificialmente, tra cui l'audio che imita persone reali. In Italia, inoltre, la legge sull'intelligenza artificiale approvata nel 2025 ha introdotto nel codice penale un reato specifico per la diffusione illecita di contenuti generati o alterati con l'IA che causano un danno. Le truffe con voci contraffatte, come le finte telefonate di familiari in difficoltà, sono già segnalate dalle forze dell'ordine. Una clonazione accessibile con mezzo minuto di audio avrebbe sollevato più di una domanda anche per i regolatori, che già seguono da vicino come i grandi fornitori di IA applicano l'AI Act.
Domande frequenti
Posso clonare la mia voce con Gemini dall'Italia?
No, secondo Google la clonazione tramite AI Studio non è disponibile nello Spazio economico europeo, di cui l'Italia fa parte. Google non ha comunicato se e quando la funzione arriverà.
Il modello parla italiano?
Sì. L'italiano è tra le lingue supportate e si possono scegliere voci predefinite o crearne di nuove descrivendole a parole.
Come si riconosce un audio creato con Gemini?
Ogni file contiene la filigrana SynthID, che non si sente ma può essere rilevata con gli strumenti di verifica di Google. Le voci clonate portano anche credenziali C2PA.
Quanto costa?
Il post di lancio non indica prezzi per l'API. Per Gemini Notebook e Google Vids Google parla di disponibilità "per tutti", senza menzionare costi aggiuntivi.