Wer KI lokal auf dem PC nutzen möchte, stellt sich schnell die Frage nach der passenden Hardware. Die gute Nachricht: Für ein kleines Sprachmodell reicht oft schon ein aktueller Laptop. Für größere Modelle, die bei Texten und Programmcode spürbar bessere Antworten liefern, zählt aber fast nur eine Größe: der verfügbare Speicher. Dieser Ratgeber erklärt, wie viel Grafik- und Arbeitsspeicher welche Modellgröße braucht, welche Geräteklassen NVIDIA dafür vorsieht, welche Rolle Macs mit gemeinsamem Arbeitsspeicher spielen und was die Einstiegsgeräte in Deutschland kosten.
Grundlage sind die Herstellerangaben von NVIDIA, die Dokumentation der verbreiteten Software Ollama und die Preise im Apple Online Store (Stand: 28. Oktober 2026). Eigene Messungen haben wir nicht durchgeführt; die Speicherwerte für einzelne Modellgrößen sind als Richtwerte zu verstehen.
Warum sollte man KI überhaupt lokal ausführen?
Bei ChatGPT, Gemini oder Claude läuft das Sprachmodell in den Rechenzentren der Anbieter. Jede Eingabe, jedes hochgeladene Dokument geht über das Internet dorthin. Ein lokal installiertes Modell arbeitet dagegen vollständig auf Ihrem Rechner. Das hat drei handfeste Vorteile:
- Datenschutz: Vertrauliche Unterlagen, Kundendaten oder private Notizen bleiben auf dem eigenen Gerät. Ollama hält in seiner FAQ ausdrücklich fest, dass das Unternehmen bei lokaler Nutzung weder Eingaben noch Daten zu sehen bekommt. Für Freiberufler und kleine Firmen, die DSGVO-Pflichten im Blick behalten müssen, ist das ein starkes Argument. Was die Cloud-Dienste speichern, haben wir im Ratgeber KI-Chatbots und Datenschutz zusammengefasst.
- Unabhängigkeit: Das Modell funktioniert auch im Zug ohne Netz, und es gibt keine Nutzungslimits oder Abo-Gebühren.
- Kontrolle: Sie entscheiden, welches Modell in welcher Version läuft. Ein Anbieter kann es nicht über Nacht austauschen oder abschalten.
Der Preis dafür: Lokale Modelle sind kleiner als die Spitzenmodelle der großen Anbieter und liefern bei komplexen Aufgaben oft schwächere Ergebnisse. Und je größer das Modell, desto anspruchsvoller wird die Hardware.
Welche Hardware ist für lokale KI am wichtigsten?
Anders als beim Spielen ist bei Sprachmodellen nicht die reine Rechenleistung der Engpass, sondern der Speicher. Ein Modell besteht aus Milliarden Zahlenwerten, den sogenannten Parametern. Damit es schnell antwortet, müssen diese Werte komplett in einem schnellen Speicher liegen:
- bei einem Windows- oder Linux-PC im Grafikspeicher (VRAM) der Grafikkarte,
- bei Apple-Rechnern mit M-Chip und bei Geräten wie DGX Spark im gemeinsamen Arbeitsspeicher (Unified Memory), den sich Prozessor und Grafikeinheit teilen.
Passt das Modell nicht hinein, lagert die Software einen Teil in den normalen Arbeitsspeicher aus und lässt ihn vom Prozessor berechnen. Das funktioniert, kostet aber viel Tempo. Mit dem Befehl ollama ps zeigt Ollama an, ob ein Modell zu 100 Prozent auf der GPU, komplett auf der CPU oder aufgeteilt läuft. Das ist der schnellste Weg, um zu prüfen, ob Ihre Hardware reicht.
Wichtig ist außerdem die Speicherbandbreite, also wie schnell Daten aus dem Speicher gelesen werden. Sie bestimmt maßgeblich, wie viele Wörter pro Sekunde das Modell ausgibt. Grafikkarten und die großen Apple-Chips liegen hier weit vor normalem PC-Arbeitsspeicher.
Wie viel Speicher braucht welches Sprachmodell?
Die Modellgröße wird in Milliarden Parametern angegeben, abgekürzt mit „B“ für das englische „billion“: Ein „8B“-Modell hat 8 Milliarden Parameter. Für die Heimanwendung werden Modelle fast immer quantisiert, also auf eine geringere Genauigkeit verkleinert. Verbreitet sind 4-Bit-Fassungen. NVIDIA empfiehlt auf seiner Entwicklerseite für das Programm llama.cpp ausdrücklich Modelle im Format Q4_K_M, weil sie ein gutes Verhältnis aus Tempo und Qualität bieten.
Bei 4 Bit belegt jeder Parameter rechnerisch ein halbes Byte. Daraus ergibt sich eine einfache Faustregel: rund 0,5 bis 0,6 GB Speicher pro Milliarde Parameter, dazu eine Reserve für den Kontext, also für den Gesprächsverlauf und eingelesene Dokumente. Ollama verwendet standardmäßig ein Kontextfenster von 4.096 Token; wer es vergrößert, braucht mehr Speicher.
| Modellgröße | Speicherbedarf (4 Bit, ca.) | Sinnvolle Hardware (Beispiele) |
|---|---|---|
| 3 bis 4 Mrd. Parameter | 2 bis 3 GB | fast jeder aktuelle Laptop, auch ohne Grafikkarte |
| 7 bis 8 Mrd. | 4 bis 6 GB | Grafikkarte mit 8 GB VRAM, Mac mit 16 GB |
| 12 bis 14 Mrd. | 7 bis 9 GB | Grafikkarte mit 12 bis 16 GB, Mac mit 24 GB |
| 27 bis 32 Mrd. | 15 bis 20 GB | Grafikkarte mit 24 bis 32 GB, Mac mit 36 bis 48 GB |
| um 70 Mrd. | 38 bis 45 GB | RTX PRO, mehrere Grafikkarten, Mac oder Mini-PC ab 64 GB |
| 120 bis 200 Mrd. | 65 bis 120 GB | Geräte mit 128 GB gemeinsamem Speicher (DGX Spark, Mac Studio) |
Die Werte sind Näherungen, keine Herstellerangaben. Je nach Modell, Kontextlänge und Software können sie um einige Gigabyte abweichen. Ein Mac kann zudem nicht seinen gesamten Arbeitsspeicher dem Modell überlassen, weil auch macOS und die geöffneten Programme Platz brauchen. Planen Sie deshalb immer etwas Luft ein.
Welche Geräteklassen empfiehlt NVIDIA?
NVIDIA unterteilt Hardware für lokale KI auf seiner Entwicklerseite in fünf Klassen. Spannend ist vor allem die Spalte mit der maximalen Modellgröße, die NVIDIA je Gerät angibt:
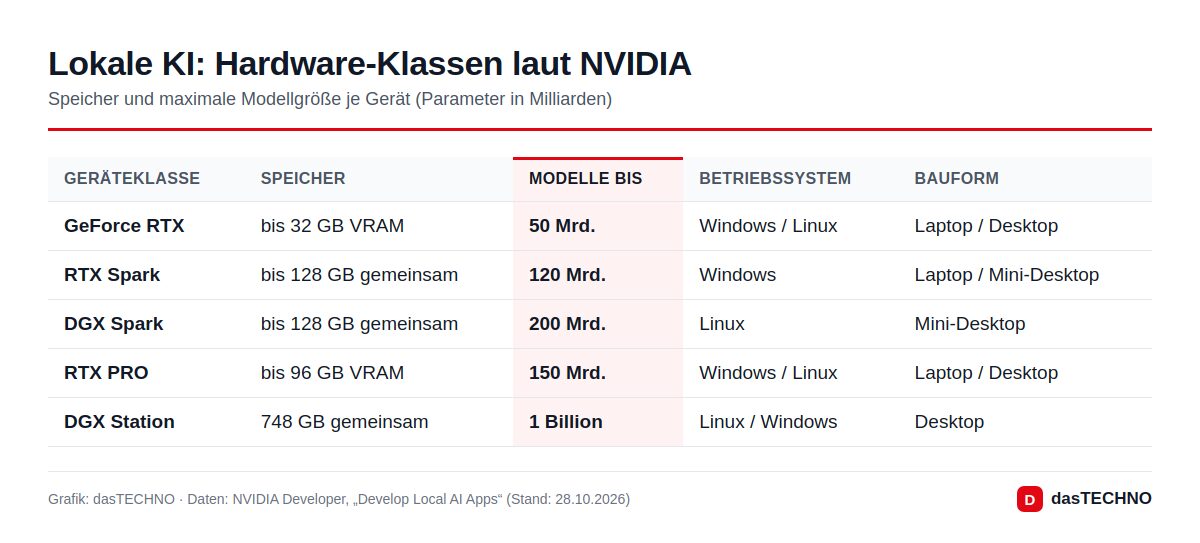
Für Privatanwender sind vor allem die ersten beiden Zeilen relevant:
- GeForce RTX: Die Gaming-Grafikkarten mit bis zu 32 GB VRAM eignen sich laut NVIDIA für Modelle bis etwa 50 Milliarden Parameter. Die 32 GB bietet nur die RTX 5090; RTX 5080 und 5070 Ti haben 16 GB, die RTX 5070 hat 12 GB. Welche Karte wie viel Speicher und welches Netzteil braucht, zeigt unsere Kaufberatung Grafikkarte.
- RTX Spark: NVIDIAs neuer Chip für Windows-Laptops und kompakte Desktops nutzt bis zu 128 GB gemeinsamen Speicher und ist laut NVIDIA für Modelle bis 120 Milliarden Parameter ausgelegt. Erstes Gerät in Deutschland ist der Surface Laptop Ultra ab 2.899 Euro; die 128 GB gibt es allerdings nicht in der Einstiegskonfiguration.
DGX Spark (Linux, bis 200 Milliarden Parameter), RTX PRO (Workstation-Karten mit bis zu 96 GB) und die DGX Station mit 748 GB richten sich an Entwickler und Unternehmen. NVIDIA nennt für die DGX Station Modelle bis zu einer Billion Parameter.
Reicht meine vorhandene Grafikkarte?
Das hängt vor allem vom Hersteller und vom Alter der Karte ab. Laut der offiziellen Ollama-Dokumentation gilt:
| Hersteller | Unterstützung in Ollama | Hinweis |
|---|---|---|
| NVIDIA | ab Compute Capability 5.0, also bis zurück zur GTX 750 Ti | Treiber ab Version 550; ältere Karten (Compute Capability 5.0 bis 6.2) brauchen Treiber ab 570 |
| AMD unter Linux | Radeon RX 9000, 7000 und 6800/6900, dazu Radeon PRO und Instinct | breiteste AMD-Unterstützung |
| AMD unter Windows | Radeon RX 7600 bis 7900 XTX | RX 9070 und 9060 stehen nur in der Linux-Liste |
| Apple | alle Macs mit M-Chip über die Metal-Schnittstelle | gemeinsamer Arbeitsspeicher wird genutzt |
| Intel und andere | über Vulkan unter Windows und Linux | Vulkan ist laut Ollama standardmäßig aktiv |
Eine Gaming-Karte der letzten Jahre mit 8 GB reicht damit für Modelle bis etwa 8 Milliarden Parameter. Wer bereits eine Karte mit 16 GB besitzt, kann Modelle mit 12 bis 14 Milliarden Parametern bequem nutzen. Besitzer einer aktuellen AMD-Karte der RX-9000-Serie sollten wissen, dass Ollama sie offiziell nur unter Linux über ROCm aufführt; unter Windows bleibt der Weg über Vulkan.
Geht lokale KI auch ohne Grafikkarte?
Ja. Fehlt eine geeignete GPU, rechnet Ollama auf dem Prozessor. Dafür sollte der Rechner mindestens 16 GB Arbeitsspeicher haben, damit neben Betriebssystem und Browser noch Platz für ein kleines Modell bleibt. Die Antworten erscheinen dann allerdings deutlich langsamer, bei mittelgroßen Modellen oft nur wenige Wörter pro Sekunde. Für kurze Fragen, Zusammenfassungen oder erste Experimente kann das genügen. Wer täglich damit arbeitet, wird sich über die Wartezeit ärgern.
Ist ein Mac die bessere Wahl für lokale KI?
Für große Modelle sind Apple-Rechner eine ernsthafte Alternative zum Gaming-PC. Der Grund ist der gemeinsame Arbeitsspeicher: Ein Mac mit 64 GB kann einen Großteil davon für ein Modell bereitstellen, während selbst die teuerste GeForce-Karte bei 32 GB endet. Die Preise im Apple Online Store Deutschland (Stand: 28.10.2026):
| Gerät | Chip | Arbeitsspeicher (wählbar) | Preis ab |
|---|---|---|---|
| Mac mini | M6 | 16 bis 32 GB | 1.049 € |
| Mac mini | M5 Pro | bis 64 GB | 1.999 € |
| Mac Studio | M5 Max | 36 bis 128 GB | 2.999 € |
| Mac Studio | M5 Ultra | 96 bis 512 GB | 6.599 € |
Die Einstiegspreise gelten für die Grundausstattung; mehr Arbeitsspeicher kostet deutlich Aufpreis. Die Variante mit 512 GB ist laut Apple ab Ende Oktober erhältlich. Welche Dimensionen damit möglich werden, zeigt Metas offenes Modell Muse Spark Open, das auf zwei Mac Studios läuft. Alle Daten der neuen Geräte finden Sie in unserer Meldung zu Mac mini und Mac Studio.
Der Nachteil: Den Arbeitsspeicher eines Macs können Sie später nicht aufrüsten. Wer unsicher ist, wie groß die Modelle werden sollen, kauft lieber eine Stufe mehr. Bei einem PC lässt sich dagegen die Grafikkarte tauschen.
Wie viel Speicherplatz brauchen die Modelle?
Ein 8-Milliarden-Modell in 4 Bit belegt auf der SSD rund 5 GB, ein 70-Milliarden-Modell rund 40 GB. Wer mehrere Modelle ausprobieren will, sollte daher einige hundert Gigabyte frei haben. Eine NVMe-SSD verkürzt die Ladezeit spürbar, wenn ein Modell zum ersten Mal in den Speicher geladen wird. Ollama legt die Dateien unter Windows im Benutzerordner unter .ollama\models ab, unter macOS in ~/.ollama/models. Standardmäßig bleibt ein Modell nach der letzten Anfrage fünf Minuten im Speicher und wird dann entladen.
Welche Software brauche ich für den Einstieg?
Für Einsteiger sind zwei Programme verbreitet:
- Ollama: kostenlos für Windows, macOS und Linux. Modelle werden mit einem Befehl heruntergeladen und gestartet. Viele andere Programme können Ollama als Grundlage nutzen.
- LM Studio: bietet eine grafische Oberfläche mit Modellsuche, eignet sich daher gut für Nutzer, die nicht mit der Kommandozeile arbeiten möchten.
Daneben nennt NVIDIA für Fortgeschrittene Programme wie llama.cpp, vLLM und TensorRT. So gehen Sie vor:
- Verfügbaren VRAM bzw. Arbeitsspeicher ermitteln (Windows: Task-Manager, Leistung, GPU; Mac: Über diesen Mac).
- Ein Modell wählen, das laut Tabelle oben mit Reserve hineinpasst.
- Mit
ollama psprüfen, ob es vollständig auf der GPU läuft. - Läuft es teilweise auf der CPU, eine kleinere Modellgröße oder eine stärkere Quantisierung wählen.
Für wen lohnt sich die Anschaffung?
| Nutzertyp | Empfehlung |
|---|---|
| Neugierige, gelegentliche Nutzung | vorhandenen Rechner nutzen, Modell mit 3 bis 8 Mrd. Parametern |
| Gamer mit aktueller Grafikkarte | Karte mit 12 bis 16 GB reicht für 8- bis 14-Mrd.-Modelle |
| Freiberufler mit vertraulichen Daten | Grafikkarte mit 16 bis 32 GB oder Mac mit 32 bis 64 GB |
| Entwickler, große Modelle | 128 GB gemeinsamer Speicher (Mac Studio, DGX Spark) |
Rein finanziell lohnt sich lokale KI selten: Ein Abo für einen Cloud-Chatbot kostet einen Bruchteil einer leistungsstarken Workstation. Wer aber regelmäßig mit vertraulichen Texten arbeitet oder ohnehin einen Gaming-PC besitzt, bekommt mit einem lokalen Modell ein nützliches Werkzeug ohne laufende Kosten.
Häufige Fragen
Wie viel VRAM brauche ich für ein lokales Sprachmodell?
Für ein Modell mit 7 bis 8 Milliarden Parametern genügen in 4-Bit-Fassung etwa 8 GB VRAM. Für 12 bis 14 Milliarden Parameter sind 12 bis 16 GB sinnvoll, für rund 30 Milliarden 24 bis 32 GB.
Kann ich lokale KI auf einem Laptop nutzen?
Ja. Kleine Modelle laufen auch auf dem Prozessor eines Laptops mit 16 GB Arbeitsspeicher, wenn auch langsamer. Laptops mit GeForce-RTX-Grafik oder Apple-M-Chip sind deutlich schneller.
Funktioniert Ollama mit AMD-Grafikkarten?
Ja. Unter Linux unterstützt Ollama laut Dokumentation Radeon-Karten ab der RX-6800-Serie bis zur RX 9070 XT, unter Windows die Modelle RX 7600 bis 7900 XTX. Andere Karten können über Vulkan laufen.
Sind lokale Modelle so gut wie ChatGPT?
Meist nicht. Die größten Cloud-Modelle sind deutlich umfangreicher als alles, was auf Heimhardware läuft. Für Zusammenfassungen, Textentwürfe und einfache Programmieraufgaben liefern gute lokale Modelle aber brauchbare Ergebnisse.
Werden meine Daten bei lokaler KI übertragen?
Bei lokaler Ausführung nicht. Ollama gibt an, Eingaben und Daten bei lokaler Nutzung nicht zu sehen. Nur wer bewusst Cloud-Modelle über die Software nutzt, schickt Anfragen an einen Server.
Fazit
Für lokale KI zählt vor allem der Speicher. Kleine Modelle laufen schon auf einem Laptop mit 16 GB Arbeitsspeicher, eine Grafikkarte mit 8 bis 16 GB VRAM bringt mittlere Modelle auf ein angenehmes Tempo. Wer Modelle mit 70 Milliarden Parametern oder mehr nutzen will, landet bei Geräten mit viel gemeinsamem Speicher wie dem Mac Studio oder DGX Spark, und damit schnell im vierstelligen Euro-Bereich. Prüfen Sie zuerst, was Ihre vorhandene Hardware schafft: Mit Ollama und dem Befehl ollama ps ist das in wenigen Minuten erledigt.